Come valutare retrieval e risposte di un assistente RAG
La risposta cita il documento corretto e sbaglia la data. Quella successiva dà la data giusta, ma non cita il paragrafo che la sostiene. La terza usa una policy superata perché il motore di ricerca l'ha messa al primo posto.
Tre errori diversi. Un solo voto alla risposta li nasconde.
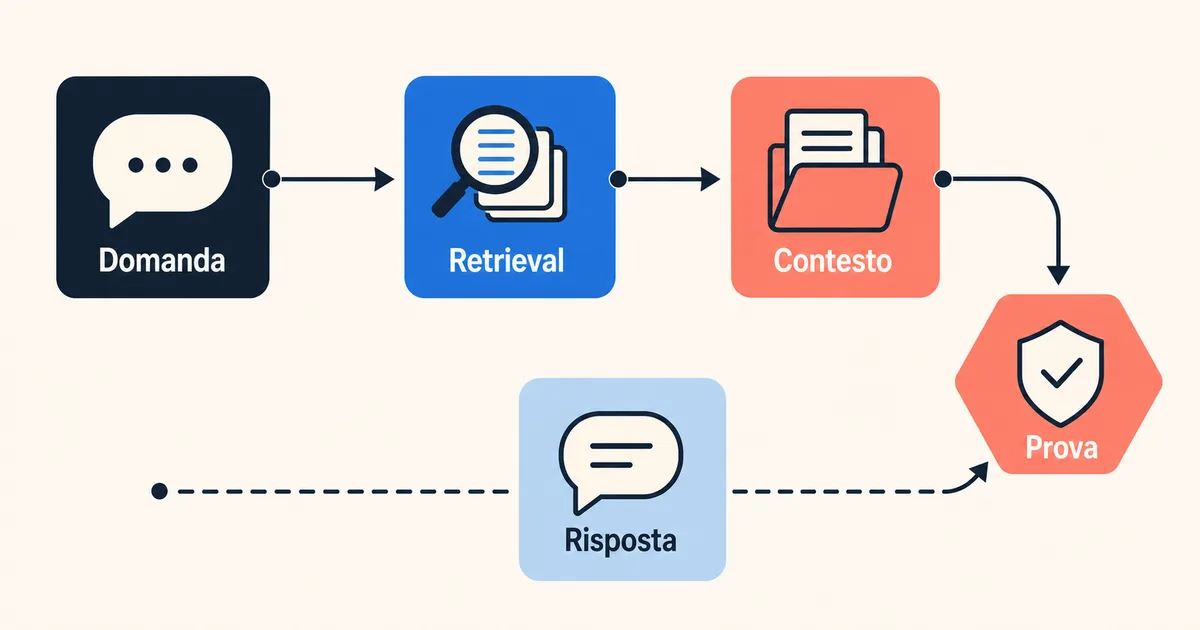
Per valutare un assistente RAG devi separare almeno due piani: ciò che il sistema recupera e ciò che il modello fa con quel materiale. Microsoft distingue proprio retrieval, groundedness, rilevanza e completezza. Se misuri soltanto l'ultima frase, non sai se correggere indice, chunk, ranking, prompt o regola di astensione.
La suite utile parte da domande reali, documenti attesi e criteri osservabili. Poi conserva ogni versione e trasforma i difetti in casi di regressione.
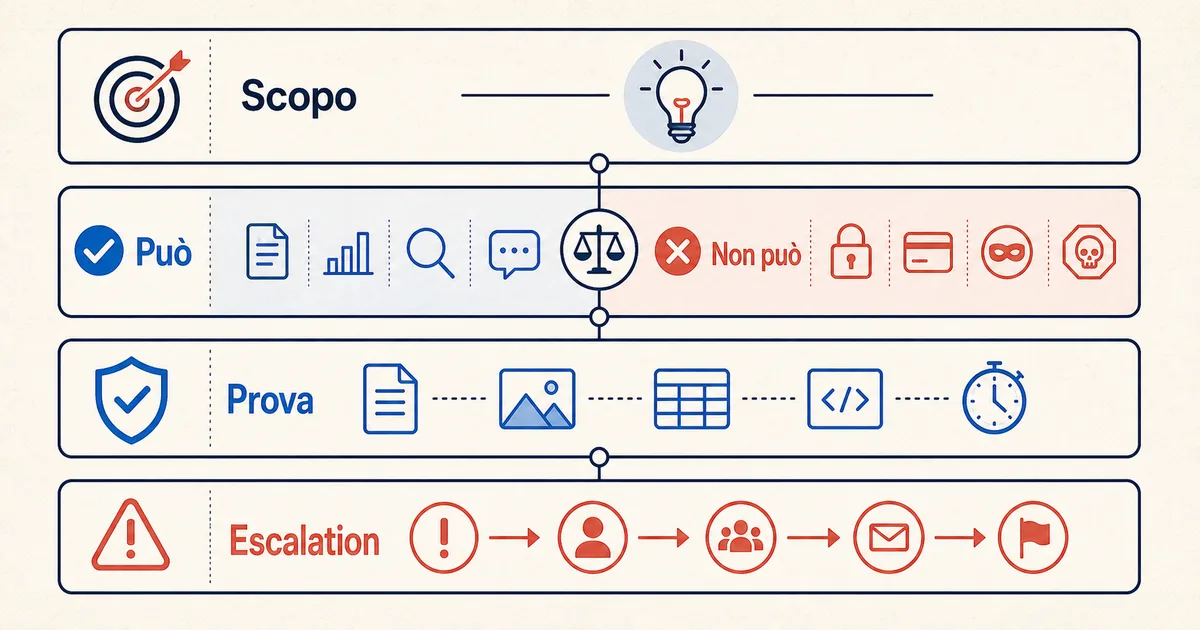
Definisci il lavoro dell'assistente
Rispondere alle domande aziendali non è un perimetro. Elenca corpus, utenti, decisioni e limite.
Per esempio:
purpose: answer-operational-procedure-questions
allowed_corpus:
  - approved-procedures
  - current-faq
users:
  - customer-operations
allowed_output:
  - answer-with-citations
  - abstain-with-reason
forbidden_output:
  - policy-exception
  - legal-interpretation
  - action-on-external-system
Il brief di un chatbot aziendale serve a chiudere questo perimetro prima dello sviluppo. La valutazione lo rende misurabile.
Scrivi anche cosa deve accadere quando la risposta non esiste, le fonti sono in conflitto o il documento è scaduto. Un assistente che parla sempre può sembrare più utile durante una demo e diventare meno affidabile nel lavoro.
Costruisci un set di casi con ground truth
Il set non è un elenco casuale di prompt. Ogni caso contiene domanda, intento, documenti attesi, risposta minima e disposizione corretta.
case_id: PROC-017
query: Quale versione del modulo va usata per la richiesta X?
expected_documents:
  - procedure-x-v4
forbidden_documents:
  - procedure-x-v3
required_facts:
  - module-id
  - effective-date
expected_disposition: answer
blocking_errors:
  - stale-source
  - unsupported-date
  - missing-citation
Inserisci casi facili, ambigui, negativi e fuori perimetro. I negativi sono decisivi: domanda senza risposta nel corpus, documento scaduto, due fonti in conflitto, richiesta che chiede un'azione vietata, dato personale non necessario.
Il dataset di test per un workflow AI offre il contenitore generale. Nel RAG devi aggiungere ground truth di retrieval: quali documenti o passaggi sono rilevanti e quali non devono essere usati.
Se non hai ground truth per tutto il corpus, parti da un campione curato con il knowledge owner. Meglio 40 casi leggibili che 4.000 domande sintetiche senza una risposta verificata.
Congela corpus, indice e configurazione
Un risultato senza versione non si può confrontare. Registra:
snapshot del corpus
documenti inclusi ed esclusi
regole di chunking
embedding e versione
filtri e metadata
top-k e strategia di ranking
prompt e modello
policy di citazione e astensione
data del test
Se cambi tre variabili insieme e il punteggio sale, non sai perché. E se il corpus riceve una nuova policy durante il test, un caso prima rosso può diventare verde senza alcuna modifica al retrieval.
I documenti devono avere identità, versione, validità e owner. manuale_finale_nuovo.pdf non permette di scartare quello superato. La valutazione inizia dalla qualità del corpus, non dall'LLM judge.
Valuta retrieval e risposta su due piani
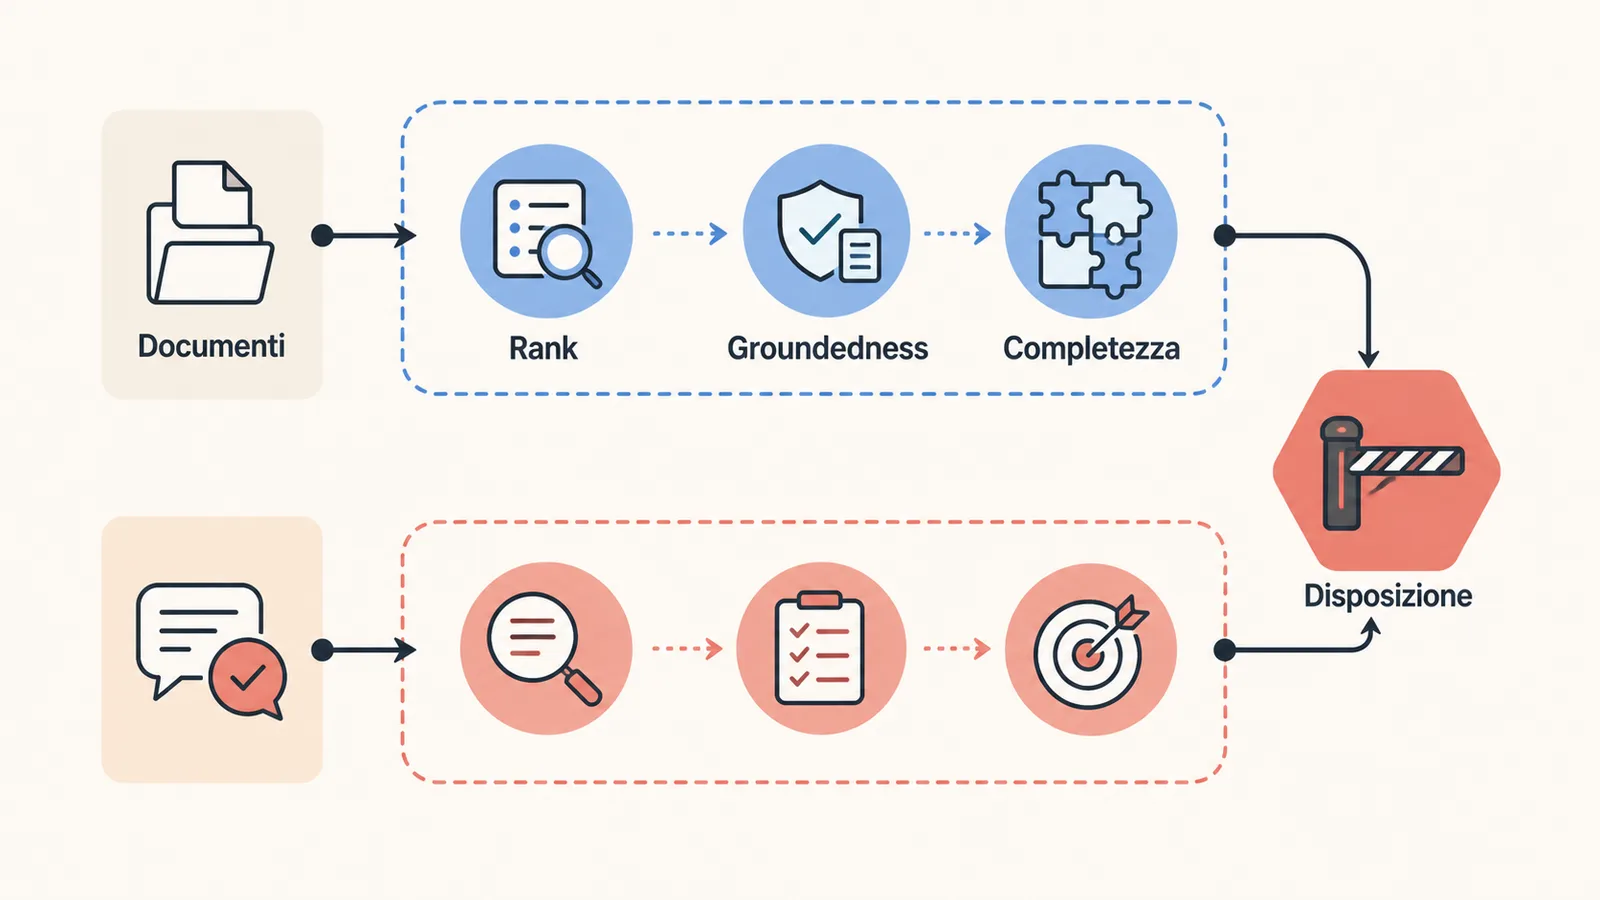
Microsoft separa la valutazione di processo da quella del risultato. Usa una scorecard che mantenga la stessa divisione.
Piano | Domanda | Evidenza |
|---|---|---|
Retrieval | ha trovato i documenti rilevanti? | ID e rank dei chunk |
Retrieval | ha escluso fonti vietate o superate? | filtri e metadata |
Risposta | ogni claim è sostenuto dal contesto? | claim e citazione |
Risposta | risponde a tutte le parti necessarie? | fatti richiesti |
Risposta | segue formato e limite? | schema e disposizione |
End-to-end | la decisione finale è quella attesa? | answer, abstain o escalate |
Un documento atteso al quinto posto può essere tecnicamente recuperato e non entrare mai nel contesto inviato al modello. Per questo conserva posizione e chunk oltre al valore found=true.
Se il retrieval è rosso, correggi corpus, metadata, chunk, embedding, query transformation o ranking. Cambiare il prompt di risposta non farà comparire un documento assente.
Separa groundedness, completezza e correttezza
Groundedness chiede se la risposta resta dentro il contesto fornito. Google collega claim e citazioni ai fatti e produce uno score di supporto. È utile, ma non basta.
Una risposta può essere grounded in una fonte sbagliata. Se il corpus contiene una data vecchia, il modello può citarla fedelmente e restare scorretto rispetto allo stato reale. Può anche essere grounded e incompleto: usa il documento giusto, risponde al primo requisito e salta il secondo.
Tratta quindi le dimensioni così:
groundedness: il claim è sostenuto dai chunk forniti?
completezza: copre tutti i fatti richiesti dal caso?
correttezza: fatti e conclusioni coincidono con la ground truth?
rilevanza: risponde alla domanda senza deviazioni?
disposizione: risponde, si astiene o passa il caso come previsto?
La checklist per verificare un output AI aiuta sul singolo risultato. La suite RAG aggiunge il percorso a monte: quali fonti sono entrate e perché.
Controlla le citazioni a livello di claim
Una citazione messa in fondo a un paragrafo lungo può sostenere solo metà delle frasi. Spezza la risposta in claim verificabili e collega ciascuno al passaggio preciso.
Per ogni claim registra:
claim_text
source_document_id
source_version
chunk_id
locator
support_status
support_reason
Il locator può essere pagina, sezione, riga o identificatore stabile del chunk. Un URL alla home del manuale non è una prova.
Google distingue score complessivo e supporto a livello di claim. Nella tua suite, un solo claim bloccante senza fonte può rendere rossa la risposta anche se la media è alta. Una data inventata non viene assorbita da quattro frasi corrette.
Prova l'astensione e l'escalation
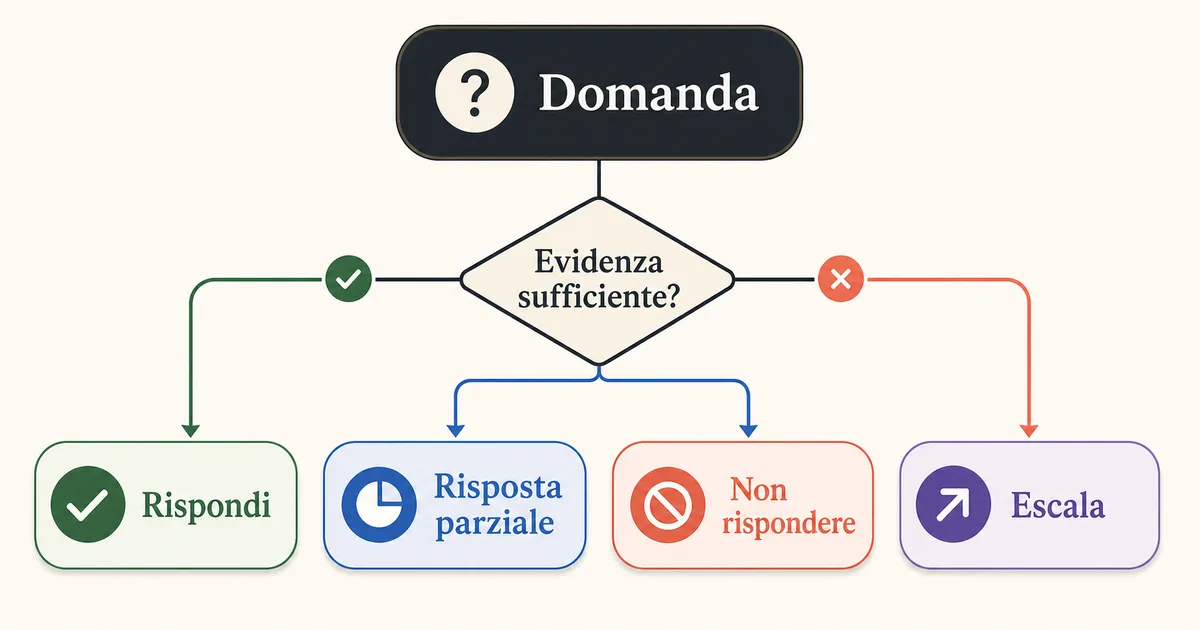
Un assistente affidabile deve saper fermarsi. Inserisci casi in cui:
il corpus non contiene la risposta
la fonte è scaduta
due documenti autorevoli sono in conflitto
la domanda chiede un'interpretazione fuori perimetro
manca un dato necessario
la risposta avrebbe una conseguenza ad alto impatto
L'esito atteso non è sempre non lo so. Può essere source_conflict, missing_required_fact, out_of_scope o human_review_required, con le fonti che spiegano il blocco.
Valuta se l'assistente evita affermazioni non sostenute, indica cosa manca e passa il caso all'owner giusto. Una risposta prudente ma vaga non è automaticamente buona. Deve aiutare la persona a fare il passo sicuro successivo.
Ripeti i casi e usa intervalli
Microsoft ricorda che le risposte dei modelli sono non deterministiche. Lo stesso caso può passare quattro volte e fallire alla quinta.
Esegui più ripetizioni per i casi critici e conserva distribuzione, errori e media. Puoi leggere:
pass rate per caso e versione
frequenza del singolo errore bloccante
variabilità delle citazioni
stabilità della disposizione
latenza e costo entro il perimetro deciso
Una soglia unica per tutto il set nasconde i casi rari e importanti. Se un assistente sbaglia una procedura critica una volta su dieci, la media degli altri casi non lo rende pronto.
Ogni modifica a corpus, chunking, retrieval, prompt o modello crea una nuova versione della prova. Mantieni fissi i casi e documenta il delta.
Trasforma gli errori in una suite di regressione
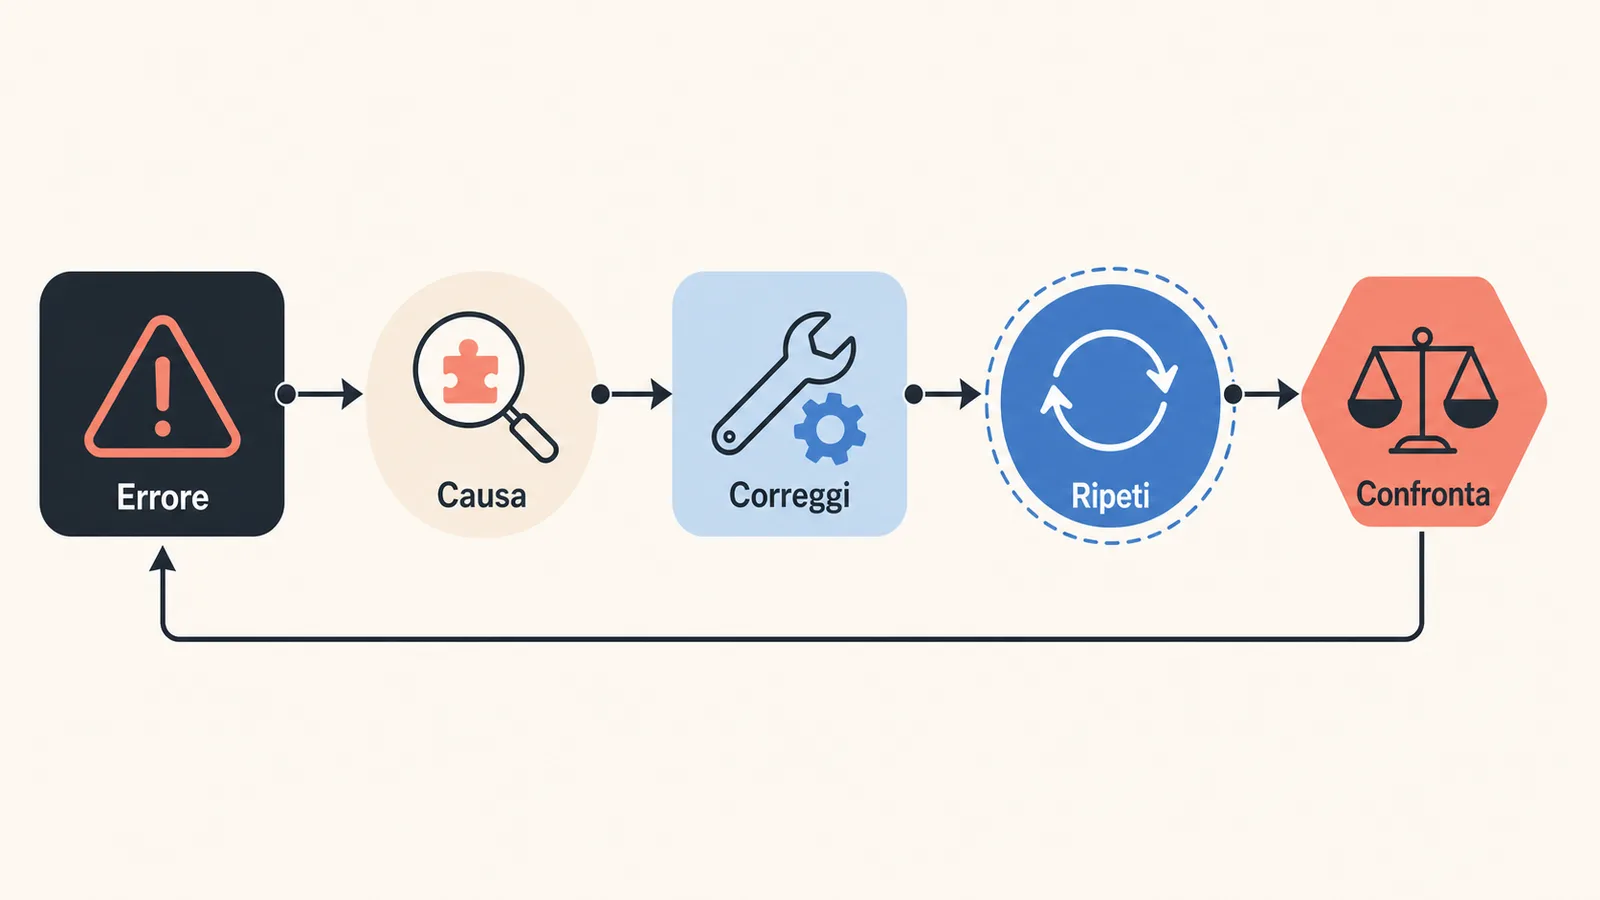
La tassonomia deve indicare dove intervenire.
Codice | Difetto | Superficie probabile |
|---|---|---|
| documento atteso assente | retrieval |
| fonte superata presente | metadata o filtri |
| chunk non pertinente in alto | ranking o chunking |
| claim senza supporto | prompt o generazione |
| fatto richiesto mancante | retrieval o risposta |
| risponde quando deve fermarsi | policy o prompt |
| citazione non sostiene il claim | mapping claim-fonte |
Quando compare un errore nuovo, salva domanda, snapshot, chunk, risposta, versione e disposizione corretta. Il caso entra nella suite. Non correggere soltanto l'esempio nel prompt: prova che la modifica non rompa casi già verdi.
Tieni una review umana mirata
Un LLM judge accelera la valutazione, ma può condividere difetti con il modello valutato. Usa regole deterministiche dove puoi: presenza del documento atteso, versione, campi obbligatori, link, citazioni e disposizione.
La review umana serve su:
ground truth iniziale
casi ambigui
correttezza di dominio
conseguenze ad alto impatto
campione dei pass automatici
disaccordi tra metriche
Il knowledge owner giudica la fonte. Il process owner giudica l'azione. Il team AI diagnostica retrieval e generazione. Un solo revisore non copre tutto.
Esempio fittizio
Un assistente risponde su procedure di acquisto interne. Il set contiene 60 casi, di cui 12 negativi. Un aggiornamento del chunking migliora il retrieval dei documenti lunghi.
La scorecard sale, ma tre domande sulla soglia di approvazione iniziano a citare una guida superata. Il documento vecchio aveva metadata incompleti e il nuovo chunking lo ha portato più in alto.
Il team non modifica il prompt. Corregge validità e filtri, ricostruisce l'indice e ripete gli stessi 60 casi cinque volte. I tre casi tornano verdi. Un negativo, però, produce ancora una risposta quando le fonti sono in conflitto. Quel difetto diventa WRONG_DISPOSITION e blocca la release della versione finché la regola di astensione non passa.
Il test ha separato due cause: retrieval vecchio e comportamento davanti al conflitto.
Think, Build, Enable applicato alla valutazione RAG
Think: definisci scopo, corpus, utenti, ground truth, errori bloccanti e disposizione attesa.
Build: crea set versionato, logging di chunk e claim, scorecard su due piani e suite di regressione.
Enable: assegna review per fonte, processo e tecnica. Ripeti i casi critici e usa i difetti per decidere cosa cambiare.
Porta knowledge base, domande e casi falliti a MAIKER HUB per progettare chatbot e assistenti AI. La valutazione utile non produce un voto elegante. Ti dice quale parte si è rotta e se la versione può entrare nel lavoro.
Domande frequenti
Quanti casi servono per iniziare?
Non esiste un numero universale. Parti dai compiti più frequenti e dai fallimenti più costosi. Ogni caso deve avere fonti e disposizione verificabili.
Groundedness alta significa risposta corretta?
No. La risposta può aderire a una fonte vecchia o sbagliata. Controlla anche validità del corpus, completezza e ground truth.
Posso usare solo un LLM judge?
No. Combina controlli deterministici, metriche assistite e review competente. Versione, documento atteso e citazione sono spesso verificabili senza un secondo modello.
Devo testare anche domande senza risposta?
Sì. Servono per verificare astensione, conflitti, richieste fuori perimetro ed escalation.
Quando aggiungo un caso alla regressione?
Quando un difetto nuovo è riproducibile e puoi scrivere l'esito corretto. Conserva snapshot, risposta, chunk e versione che lo hanno generato.