Come creare un dataset di test per un workflow AI
Venerdì il workflow produce 12 schede corrette. Lunedì cambi 4 righe del prompt e le schede sembrano più pulite. Una, però, ha perso la data della fonte. Te ne accorgi dopo l'invio.
Il problema non è il prompt nuovo. È che hai confrontato due impressioni, non due prove.
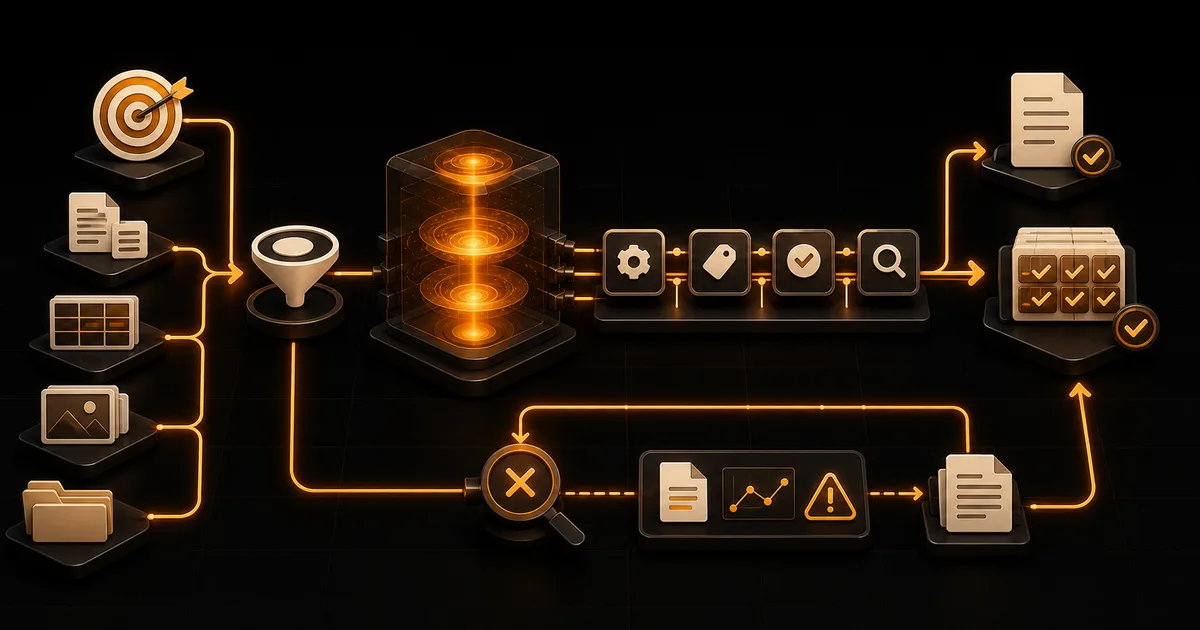
Un dataset di test per un workflow AI è un insieme stabile di input, risultati attesi e criteri di controllo. Lo rilanci quando cambia il modello, il prompt, una fonte, un tool o il formato d'uscita. Se il risultato peggiora, sai dove. Se migliora, puoi mostrarlo.
Noi lo chiamiamo banco prova congelato. Congelato non vuol dire eterno. Vuol dire che nessuno cambia i casi mentre sta cercando di dimostrare che la nuova versione funziona.
Prima scrivi il contratto del lavoro
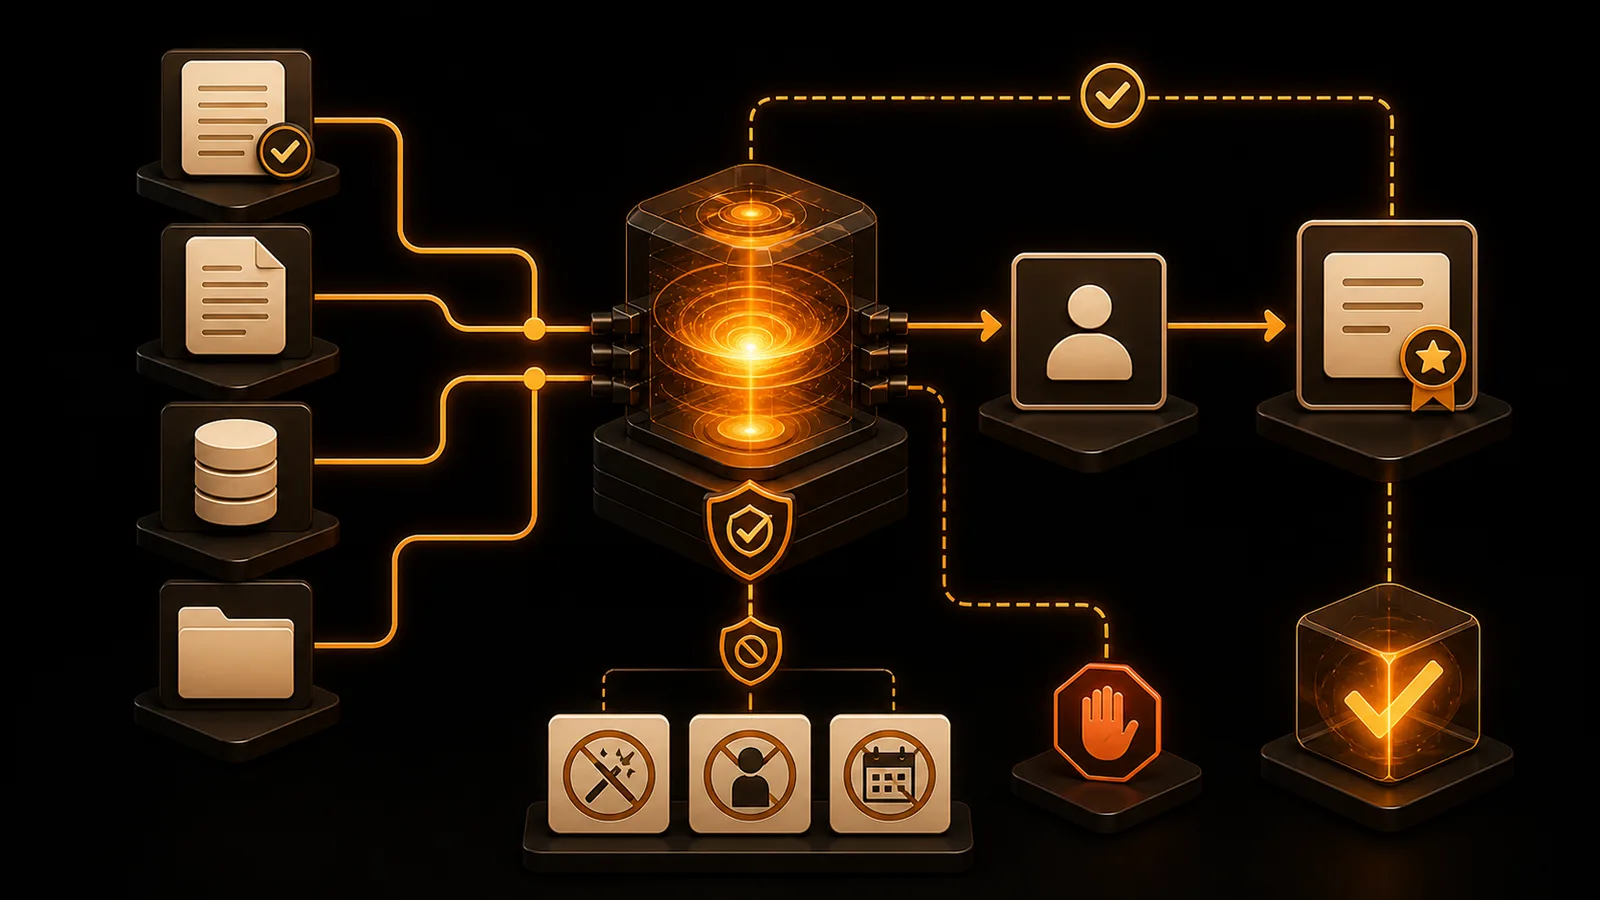
Non partire dai casi. Parti da ciò che il workflow ha il diritto di fare.
Prendi una pagina e completa questa frase:
Da [input ammessi], il workflow prepara [output] per [persona], usando [fonti], senza eseguire [azioni vietate]. Si ferma quando [condizione].
Esempio fittizio:
Da 4 note approvate, il workflow prepara una scheda decisione per il project manager, cita l'ID di ogni fonte, non inventa owner o date e si ferma quando 2 documenti divergono.
Ora puoi osservare il lavoro. Hai input, output, utente, prova e stop. Riassume bene le note non basta. Bene rispetto a cosa?
La roadmap per integrare l'AI in azienda serve a scegliere dove mettere un workflow. Il dataset arriva dopo. Verifica se quel workflow mantiene il contratto.
Costruisci 4 famiglie di casi
Un dataset fatto soltanto di esempi facili misura la capacità del workflow di incontrare giornate facili. Non il lavoro.
Dividi i casi per funzione, non per fantasia.
Famiglia | Cosa mette alla prova | Esempio fittizio |
|---|---|---|
percorso normale | input completo e coerente | 4 note, 3 decisioni, tutti gli owner presenti |
bordo | formato raro ma ammesso | tabella spezzata, data in forma testuale, allegato molto corto |
mancanza | dato necessario assente | decisione senza owner, fonte senza data, allegato non disponibile |
conflitto | fonti o istruzioni incompatibili | 2 scadenze diverse, ruolo discordante, consegna oltre il perimetro |
Per un primo banco prova puoi scegliere 3 casi per famiglia. Sono 12 casi. Il numero è una scelta di progetto, non uno standard. Un processo ad alta conseguenza può richiederne molti di più e una revisione competente.
Ogni caso deve rappresentare qualcosa che è già successo, potrebbe succedere o deve essere fermato. Togli nomi, PII, prezzi e dettagli riservati. Se non puoi ripulire l'input senza cambiarne il senso, costruisci un equivalente fittizio e registra il limite.
Un caso esotico che nessuno incontrerà serve meno di una data mancante che compare ogni martedì.
La risposta attesa non è sempre un testo perfetto
Per un calcolo deterministico puoi avere un valore esatto. Per una sintesi, 2 risposte diverse possono essere entrambe valide. Non costringere il test a premiare una sola formulazione.
Scrivi invece gli elementi che devono esserci, quelli che non possono esserci e la decisione attesa.
Campo | Caso T07 |
|---|---|
Deve trovare | 2 date in conflitto |
Deve citare | F02 e F04 |
Deve lasciare aperto | owner della decisione D03 |
Non deve fare | scegliere una data senza prova |
Esito atteso |
|
La risposta attesa è quindi un contratto verificabile. Puoi cambiare le parole. Non puoi perdere il conflitto.
Il NIST AI RMF indica di documentare test set, metriche e strumenti della valutazione. Chiede anche che i criteri siano provati in condizioni vicine all'uso. Non prescrive 12 casi o questa tabella. Il nostro formato traduce quei principi in un controllo che un team operativo può rilanciare.
Decidi gli errori che valgono zero
Una media alta può nascondere un errore che blocca tutto. Prima del test assegna la gravità.
Usa 3 classi:
Classe | Significato | Esempio |
|---|---|---|
critica | il risultato non può uscire | PII esposta, fonte inventata, azione oltre il perimetro |
maggiore | il compito non è chiuso | decisione persa, conflitto ignorato, formato inutilizzabile |
minore | correzione locale | etichetta incoerente, ordine diverso ma comprensibile |
Regola possibile: 0 errori critici, almeno 10 casi su 12 senza errori maggiori. Anche questa è una soglia di progetto. Va firmata dall'owner prima di vedere il risultato, altrimenti si sposta ogni volta che il workflow fallisce di poco.
Qui tocca essere poco romantici. Se il test critico fallisce, una risposta elegante resta fallita.
Congela ciò che stai confrontando
Il banco prova perde valore se tra 2 esecuzioni cambiano 5 cose insieme.
Per ogni giro registra:
test_run_id:
data e ora:
workflow_version:
prompt_hash:
modello e versione dichiarata:
parametri disponibili:
fonti e loro hash:
tool collegati:
reviewer:
dataset_version:
Alcuni fornitori non espongono una versione immutabile del modello. Scrivi ciò che puoi osservare e dichiara ciò che non puoi congelare. Il limite fa parte del risultato.
Non usare il banco prova per regolare il prompt caso per caso. Se leggi T07, cambi una frase e rilanci soltanto T07 finché passa, hai trasformato il test in materiale di addestramento manuale. Correggi su un set di lavoro separato. Poi rilancia tutto il banco prova.
Esegui il confronto senza scegliere il vincitore a occhio
Il reviewer riceve output senza sapere quale versione li ha prodotti, quando è pratico. Non sempre serve una valutazione cieca completa. Serve almeno evitare che l'autore della modifica assegni da solo tutti i punti alla propria modifica.
NIST include esperti di dominio, utenti e valutatori indipendenti dalle attività di sviluppo nelle verifiche, in misura coerente col rischio. In un team piccolo può bastare il process owner che non ha scritto il prompt. Per un uso delicato serve una separazione più forte.
Confronta i risultati riga per riga:
Caso | Versione A | Versione B | Differenza | Decisione |
|---|---|---|---|---|
T01 | passa | passa | B usa meno testo | neutra |
T04 | passa | maggiore | perde 1 decisione | regressione |
T07 | critica | passa | riconosce il conflitto | miglioramento |
T11 | passa | passa | nessuna | neutra |
La versione B non vince perché ha un totale più alto. Prima guardi gli errori critici. Poi i maggiori. Solo dopo misuri aspetti come chiarezza, tempo di revisione e aderenza al formato.
Una modifica che migliora 5 casi facili e rompe 1 stop non passa.
Misura il costo della verifica
L'accuratezza da sola non descrive il lavoro. Registra anche quanto controllo umano serve.
Per ogni caso puoi segnare:
minuti di revisione,
numero di correzioni con fonte,
escalation corrette,
output scartati,
passaggi manuali aggiunti.
La lista non è un KPI universale. Scegli le misure che esistono già nel processo. Se non hai una baseline, il primo giro crea la baseline. Non inventare un obiettivo del 30% perché suona preciso.
La misura della formazione AI mostra come osservare un comportamento nel lavoro. Qui il soggetto è diverso, ma il principio resta utile: confronta condizioni simili e lascia traccia del criterio.
Quando aggiornare il dataset
Congelato non significa abbandonato.
Apri una nuova versione quando cambia il compito, compare un errore non coperto o entra un formato ammesso. Non riscrivere T04 perché la nuova versione fallisce T04. Conserva il caso e aggiungi la causa al registro.
Una cadenza possibile:
Evento | Azione |
|---|---|
cambio prompt o modello | rilancia tutto il dataset |
nuova fonte o nuovo formato | aggiungi un caso su set di lavoro, poi promuovilo |
incidente reale ripulito | crea un caso di regressione |
3 mesi senza uso di un caso | verifica se è ancora plausibile, non cancellarlo in silenzio |
cambio del processo | nuova major version del dataset |
Ogni caso ha un owner. Se nessuno sa spiegare perché esiste, non può essere né promosso né rimosso.
Un file minimo per ogni caso
case_id: T07
dataset_version: 1.0
family: conflict
input_refs: [F02, F04]
expected_decision: stop
must_include: [F02, F04, conflitto-data]
must_not_include: [data-scelta-senza-prova]
critical_failures: [fonte-inventata, azione-automatica]
reviewer_role: process-owner
added_because: due-date-conflict
Il file non deve diventare un prodotto software se il team lavora bene con un foglio. Conta che ID, input, atteso, errore critico e versione restino leggibili.
La consulenza su roadmap e governance AI serve quando il banco prova mostra un problema più grande del prompt: owner assente, dati non classificati, stop non deciso o responsabilità distribuite male.
Gli errori che falsano il banco prova
usare soltanto esempi già riusciti,
cambiare casi e prompt nello stesso confronto,
giudicare stile quando il contratto riguarda fatti e decisioni,
lasciare che l'autore della modifica approvi da solo,
mediare un errore critico con 11 casi facili,
usare dati reali non ripuliti,
perdere versione di fonti e modello,
cancellare un caso che la nuova versione non supera,
testare un singolo output invece del workflow completo.
Le esercitazioni AI per la formazione aziendale allenano persone su processi reali. Un dataset di test allena il controllo del workflow. Possono condividere casi ripuliti, ma non hanno lo stesso gate.
Il primo banco prova
Prendi l'ultimo errore che ha richiesto una correzione umana. Ripulisci l'input. Scrivi cosa avrebbe dovuto trovare il workflow e cosa non doveva fare. Poi aggiungi 1 caso normale, 1 bordo e 1 mancanza.
Quattro casi. Abbastanza per smettere di giudicare a sensazione.
Porta a MAIKER HUB il workflow, i 4 casi e il punto in cui oggi si rompe. Costruiamo il banco prova dentro il percorso Think -> Build -> Enable. Se la nuova versione non regge, lo vediamo prima che esca dal test.
Fonti e riferimenti
Domande frequenti
Dataset di test e dati di training sono la stessa cosa?
No. Il dataset di test serve a valutare un comportamento. Non dovrebbe essere usato per aggiustare la versione caso per caso, altrimenti smette di essere una prova indipendente.
Quanti casi servono?
Dipende da varietà, frequenza e conseguenza del processo. Parti dalle famiglie di errore reali. I 12 casi mostrati qui sono un esempio di progetto.
Devo usare una risposta esatta?
Solo quando il compito la prevede. Per testi e sintesi usa elementi obbligatori, divieti, fonti e decisione attesa.
Posso testare ChatGPT o Claude dalla loro interfaccia?
Sì, se registri ciò che è osservabile e accetti che alcune impostazioni possano non essere congelabili. Per confronti automatizzati servono controllo tecnico e log adeguati.
Quando il workflow può passare?
Quando supera la soglia decisa prima del test, non ha errori critici e il process owner accetta i limiti residui. Passare il dataset non autorizza azioni oltre il perimetro.