Come usare i worktree per sessioni parallele in Claude Code
Aprire due sessioni Claude Code sullo stesso checkout non crea due ambienti indipendenti. Entrambe vedono gli stessi file sul disco e possono modificare lo stesso stato. Una sessione aggiorna una dipendenza mentre l'altra sta eseguendo i test; una rinomina un componente che l'altra continua a usare; entrambe descrivono un risultato corretto rispetto a momenti diversi del progetto.
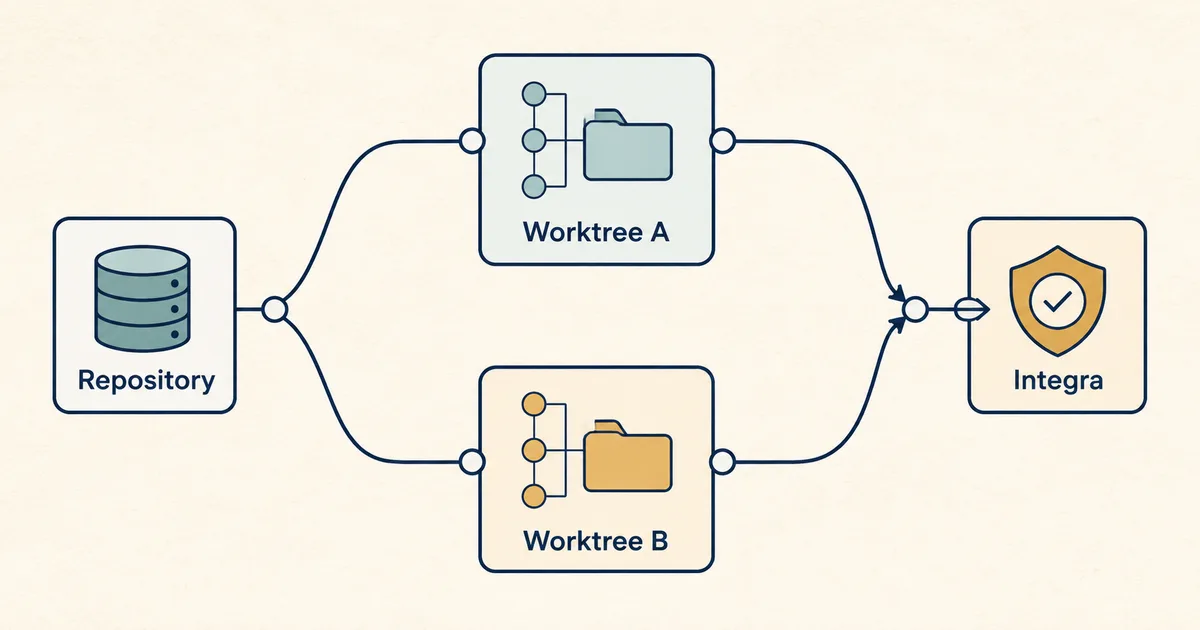
I worktree Git permettono di collegare allo stesso repository più directory di lavoro. Ogni attività può avere file e branch propri, così una sessione non cambia il checkout dell'altra. Claude Code documenta un flusso specifico per eseguire sessioni isolate in worktree separati. Anthropic, sessioni parallele con worktree.
L'isolamento fisico è soltanto il primo livello. Prima devi verificare che i due incarichi siano davvero parallelizzabili. Dopo devi integrare i risultati in un ordine controllato, aggiornando e provando il progetto a ogni passaggio.
Due sessioni non significano due lavori indipendenti
Due ticket diversi possono toccare la stessa decisione. Immagina una sessione che modifica il modello Cliente e un'altra che costruisce un'importazione CSV per quel modello. I file potrebbero anche non sovrapporsi, ma la seconda attività dipende dallo schema deciso dalla prima. Separarle in due directory evita collisioni immediate, non elimina la dipendenza.
Lo stesso vale per configurazioni, migrazioni, lockfile, API condivise, dati di test e servizi locali. Se entrambe le sessioni usano lo stesso database di sviluppo, una modifica può alterare le prove dell'altra pur avendo worktree distinti.
Il punto non è quindi “posso aprire due worktree?”, ma “posso definire per ciascun incarico un risultato e una prova che restano validi mentre l'altro avanza?”. Se la risposta è incerta, inizia con il piano e lavora in sequenza fino a quando il confine non è chiaro.
Il test di parallelizzabilità
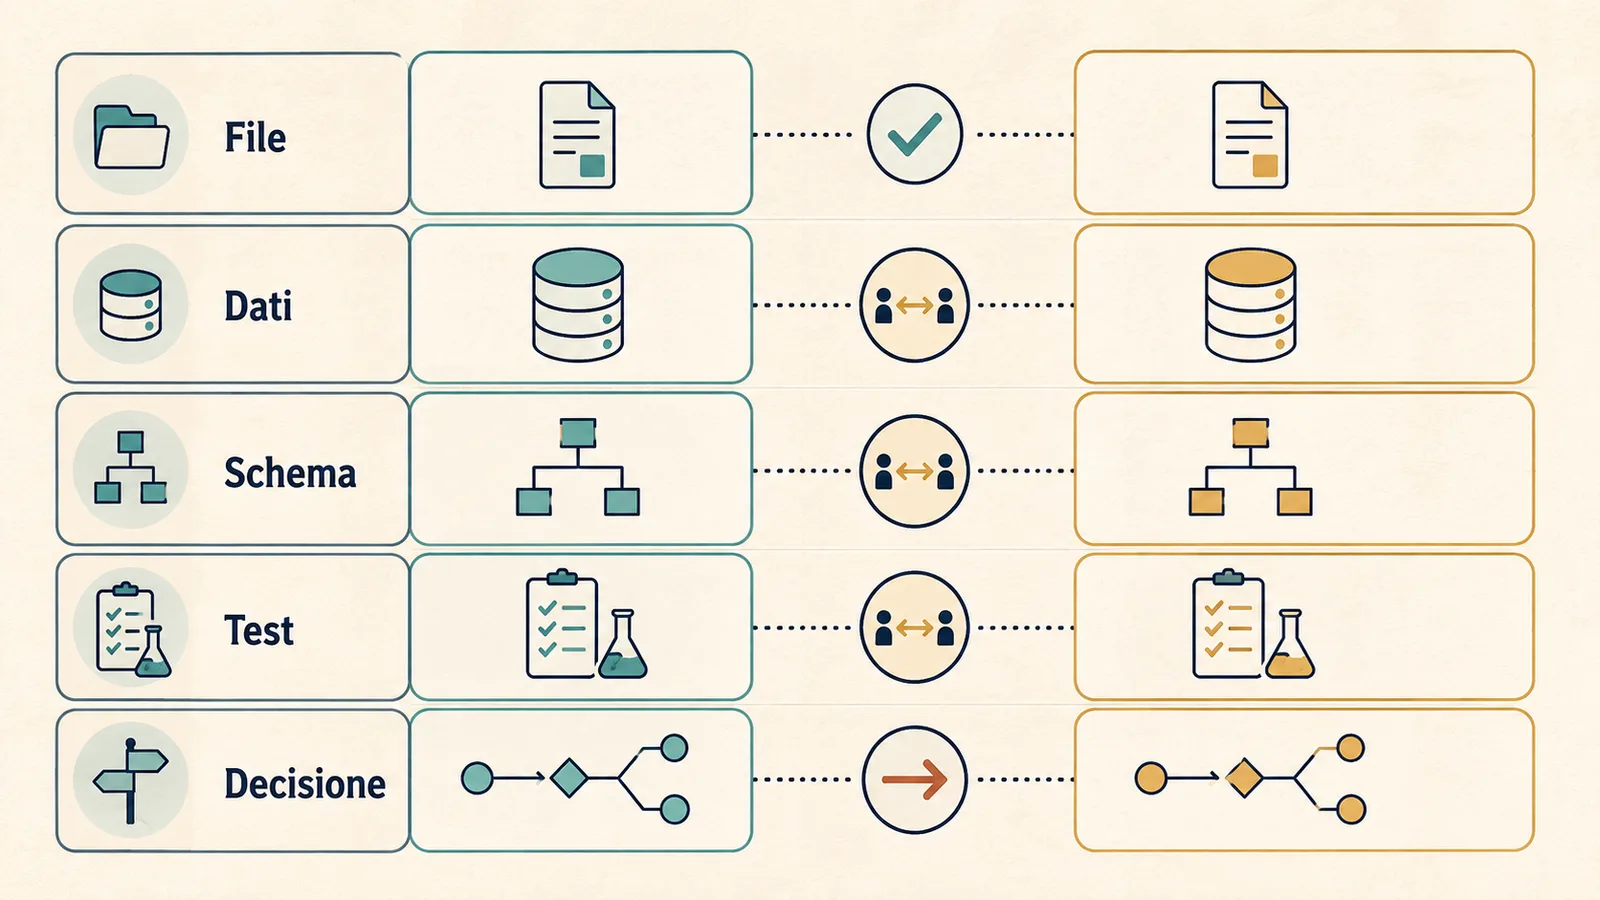
Valuta cinque superfici prima di separare il lavoro:
Superficie | Domanda | Segnale di dipendenza |
|---|---|---|
File | Le attività modificano gli stessi percorsi? | componenti, configurazioni o lockfile comuni |
Dati | Usano lo stesso stato esterno o fixture? | database condiviso, coda o cache comune |
Schema | Una cambia il contratto usato dall'altra? | tipi, API, migrazioni o eventi |
Test | Le prove dipendono dallo stesso ambiente? | porte, servizi o snapshot condivisi |
Decisione | Una richiede una scelta ancora aperta nell'altra? | naming, comportamento o compatibilità |
Il verde richiede confini espliciti su tutte le superfici pertinenti. Il giallo indica una dipendenza gestibile con un contratto temporaneo, per esempio un'interfaccia già concordata. Il rosso indica che l'ordine fa parte del lavoro: le attività devono procedere in sequenza.
Non usare il numero di file come scorciatoia. Due modifiche su cartelle lontane possono condividere lo stesso schema. Due modifiche nello stesso modulo possono invece essere separabili se una è soltanto documentazione e l'altra ha un perimetro stabile, ma l'integrazione va comunque provata.
Che cosa isola un worktree
Git descrive un worktree come una directory di lavoro collegata al repository. Più working tree possono condividere la storia e gli oggetti Git, mentre ciascuno mantiene il proprio checkout e alcuni file amministrativi. Git, documentazione git-worktree.
In pratica, una struttura può apparire così:
progetto/                 branch main
../progetto-export/       branch task/export-clienti
../progetto-dashboard/    branch task/dashboard-clienti
La sessione A lavora nella seconda directory; la sessione B nella terza. Un cambiamento non appare automaticamente nei file dell'altro worktree. Questo rende più leggibile lo stato di ogni incarico e riduce il rischio che una sessione incorpori modifiche ancora instabili dell'altra.
Restano però condivisi il repository e la destinazione finale. I branch dovranno essere aggiornati, revisionati e integrati. Possono inoltre esistere risorse fuori da Git: database, variabili d'ambiente, servizi, cartelle generate e credenziali. Il contratto di ogni sessione deve nominare anche queste superfici.
Prepara un contratto per ogni sessione
Prima delle modifiche, usa la modalità plan o un passaggio equivalente per fare leggere il progetto e proporre un piano. La documentazione sui permessi di Claude Code distingue modalità e regole che permettono di controllare le azioni. Anthropic, permessi di Claude Code.
Per ciascuna sessione registra:
Incarico: importazione clienti da CSV.
Worktree: ../progetto-export.
Branch: task/export-clienti.
File ammessi: src/import/**, tests/import/**, docs/import.md.
File vietati: schema condiviso, lockfile, configurazione deploy.
Contratto dipendente: tipo Cliente alla revisione abc123.
Prove: unit test import, fixture sintetiche, lint del modulo.
Consegna: commit locali e nota con file, test e limiti.
Azioni escluse: merge, push, deploy, modifiche al database condiviso.
Il riferimento alla revisione rende esplicito lo stato su cui si basa il lavoro. Se il contratto cambia, la sessione deve fermarsi o aggiornare il proprio branch prima di proseguire. Non lasciare che una dipendenza venga recuperata casualmente dall'altro worktree.
Avvia i worktree con nomi riconoscibili
Scegli directory e branch che descrivano l'incarico. La forma esatta dei comandi dipende dalla situazione del repository, ma il modello può essere:
git worktree add ../progetto-export -b task/export-clienti main
git worktree add ../progetto-dashboard -b task/dashboard-clienti main
git worktree list
Controlla sempre l'output di git worktree list e lo stato Git dentro ogni directory prima di avviare la sessione. Non presumere che il terminale sia nel percorso corretto. Inserisci nel prompt il path del worktree, il branch atteso e il commit di partenza.
Non copiare a mano una directory .git e non assegnare lo stesso branch a due working tree ordinari. Usa i meccanismi previsti da Git e consulta la documentazione per casi particolari, come branch già in uso, worktree bloccati o percorsi rimossi.
Prove locali e file condivisi
Ogni sessione deve avere prove che non dipendano dal risultato non ancora integrato dell'altra. Se serve un contratto comune, congelane una versione. Per un'API può essere uno schema; per una funzione un tipo e alcuni casi di test; per un'importazione una fixture con output atteso.
Evita che le due sessioni riscrivano meccanicamente file generati o lockfile condivisi se non è indispensabile. Se entrambe devono aggiornare la stessa dipendenza, probabilmente quel cambiamento merita un incarico separato da integrare prima.
Per i servizi locali, assegna database, porte o namespace distinti quando possibile. Se non puoi farlo, esegui le prove una sessione alla volta e registra quale stato era attivo. Il worktree non protegge da collisioni esterne al filesystem.
Applica un controllo delle modifiche nei workflow AI: prima delle modifiche definisci il perimetro, dopo controlla il diff reale e confrontalo con quello autorizzato.
Integra una modifica alla volta
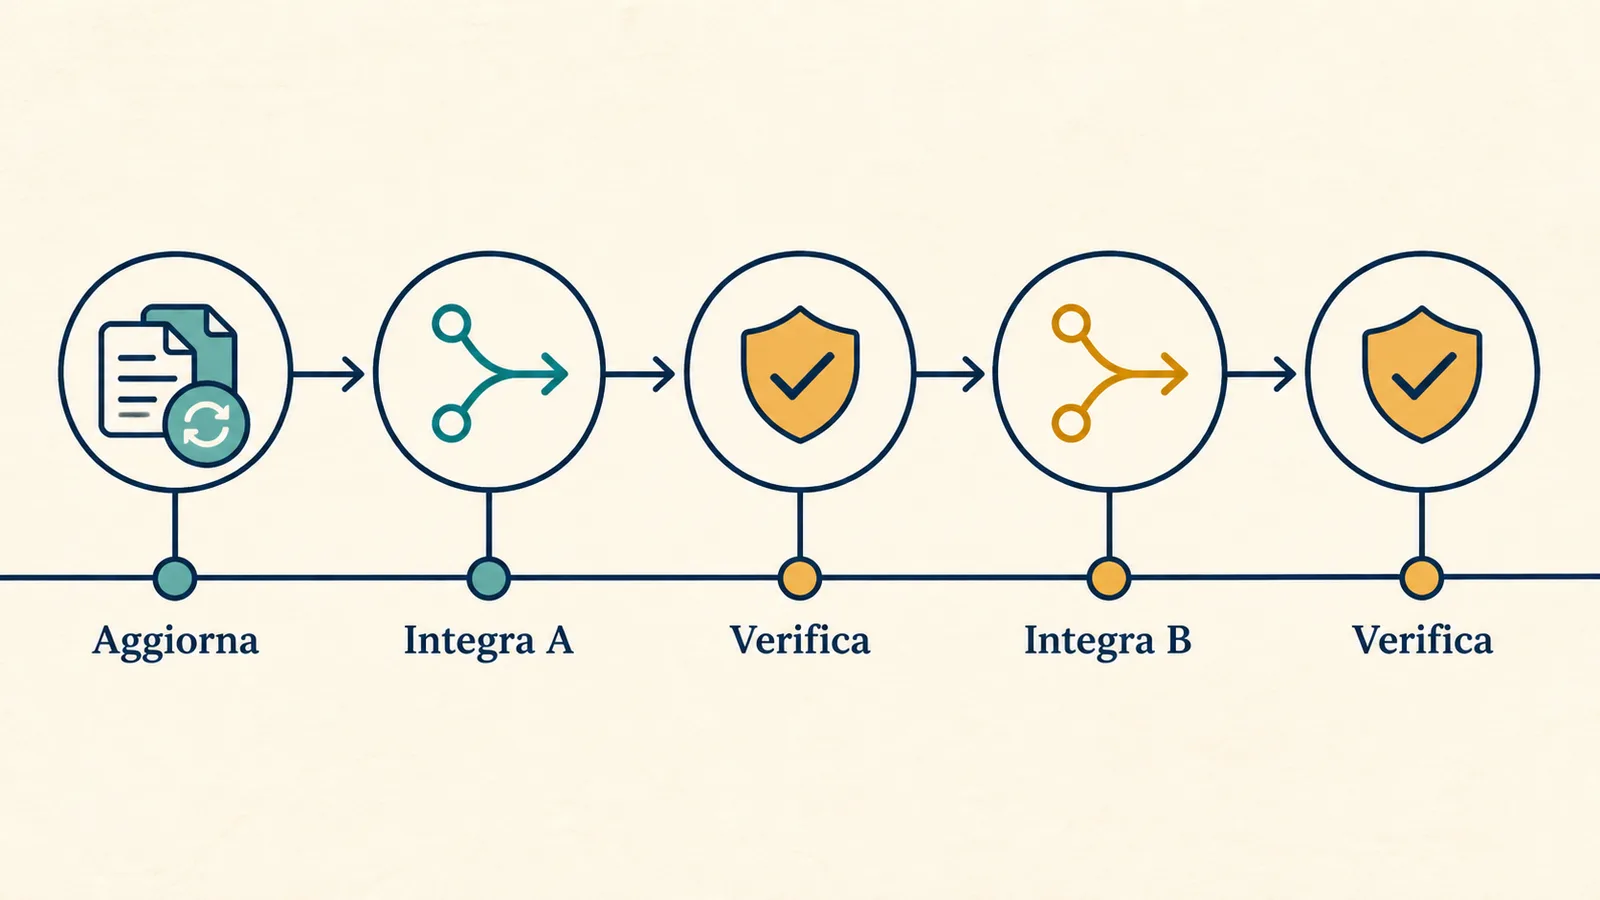
Non unire entrambi i branch e poi cercare di capire quale abbia rotto il progetto. Parti dal branch di destinazione aggiornato, integra un incarico, esegui le prove concordate e soltanto dopo passa al secondo.
La sequenza è:
aggiorna il branch di integrazione e verifica che sia pulito;
integra il branch A con una strategia conforme alla policy del team;
esegui test, build e controlli pertinenti;
aggiorna il branch B rispetto al nuovo stato;
risolvi conflitti nel contesto dell'incarico B;
integra B ed esegui di nuovo le prove complessive.
Se il secondo branch modifica una premessa introdotta dal primo, non trattare il conflitto come un semplice problema di righe. Torna al contratto funzionale. Può essere necessario adattare la soluzione o rifiutare una delle due modifiche.
Conserva una nota di integrazione con commit, test eseguiti, conflitti e decisioni. Se una fase può essere ripetuta, progetta anche retry idempotenti nel workflow, evitando comandi che duplicano dati o producono effetti non controllati.
Ripulisci senza perdere lavoro
Un worktree non va rimosso finché il suo lavoro non è stato verificato come integrato o esplicitamente conservato. Prima controlla lo stato, i commit non pubblicati secondo la policy del team e gli eventuali file non tracciati. La directory può contenere risultati che Git non conserva.
Quando l'incarico è chiuso, segui la procedura Git adatta per rimuovere il worktree e, separatamente, valuta il branch. Non trasformare la pulizia in una scorciatoia distruttiva. Se lo stato è ambiguo, fermati e conserva il worktree finché una persona non decide cosa mantenere.
Registra anche i servizi o gli ambienti creati per l'attività. La rimozione della directory non spegne necessariamente processi locali né elimina risorse esterne. File, branch e infrastruttura hanno cicli di vita distinti.
Quando è meglio lavorare in sequenza
Lavora in sequenza quando entrambe le attività toccano una migrazione, cambiano lo stesso contratto, dipendono da una decisione aperta o non possono avere ambienti di prova separati. La sequenza è utile anche quando il costo della revisione supera il beneficio del parallelismo.
Un altro segnale è l'incarico difficile da descrivere. Se non riesci a indicare file ammessi, output e prova senza usare formule come “sistema tutto ciò che serve”, non hai ancora un confine adatto a una sessione parallela.
Il worktree è uno strumento di isolamento, non un obiettivo. Usalo quando rende più semplice attribuire cambiamenti e verificare risultati. Se aggiunge branch, ambienti e riconciliazioni a un'attività di pochi minuti, il flusso lineare può essere più chiaro.
Prova il metodo sul tuo repository
Scegli due attività reali e applica il test su file, dati, schema, test e decisioni. Se entrambe superano il controllo, crea due worktree con contratti separati e integra una modifica alla volta. Se emerge una dipendenza, hai ottenuto un'informazione utile prima di moltiplicare il lavoro.
Nel programma su Claude Cowork e Code di MAIKER HUB puoi progettare sessioni, permessi e verifiche sul tuo flusso, partendo da un repository o da un processo concreto. La capacità da costruire non è aprire più sessioni, ma sapere quali incarichi possono avanzare senza perdere controllo.
Domande frequenti
Un worktree è una copia completa del repository?
Ha una directory di lavoro distinta, ma resta collegato allo stesso repository e ne condivide gli oggetti. Non va trattato come un backup indipendente.
Posso usare lo stesso branch in due worktree?
Git applica regole specifiche ai branch già associati a un working tree. Il flusso ordinario più chiaro usa un branch distinto per ciascun incarico.
I worktree eliminano i conflitti di merge?
No. Separano il lavoro durante l'esecuzione. Se due branch cambiano le stesse righe o decisioni incompatibili, il conflitto riappare durante l'aggiornamento o l'integrazione.