Come progettare una knowledge base RAG
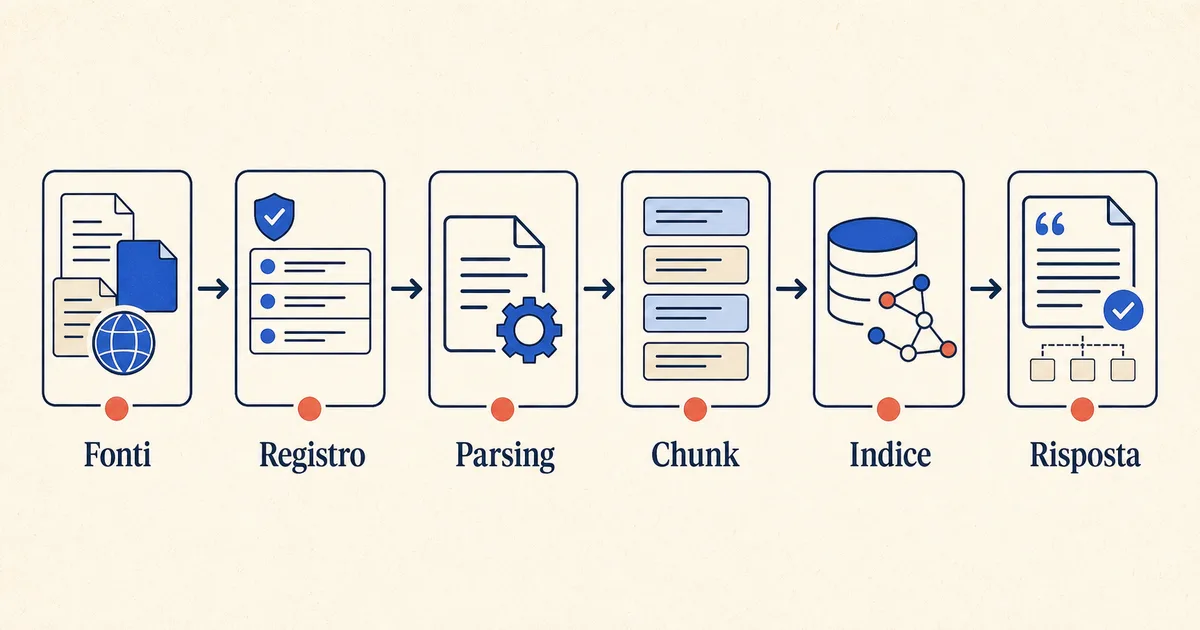
Una knowledge base RAG non è una cartella collegata a un modello. È una collezione pubblicata: ha un confine, fonti ammesse, regole di precedenza, versioni, un owner e una ricevuta per ogni aggiornamento.
Questa distinzione evita un errore comune. Il team sincronizza tutti i documenti disponibili, il retrieval trova passaggi plausibili e l'assistente risponde con sicurezza. Ma nessuno sa se la procedura era corrente, se il PDF era una bozza o quale fonte prevaleva in caso di conflitto.
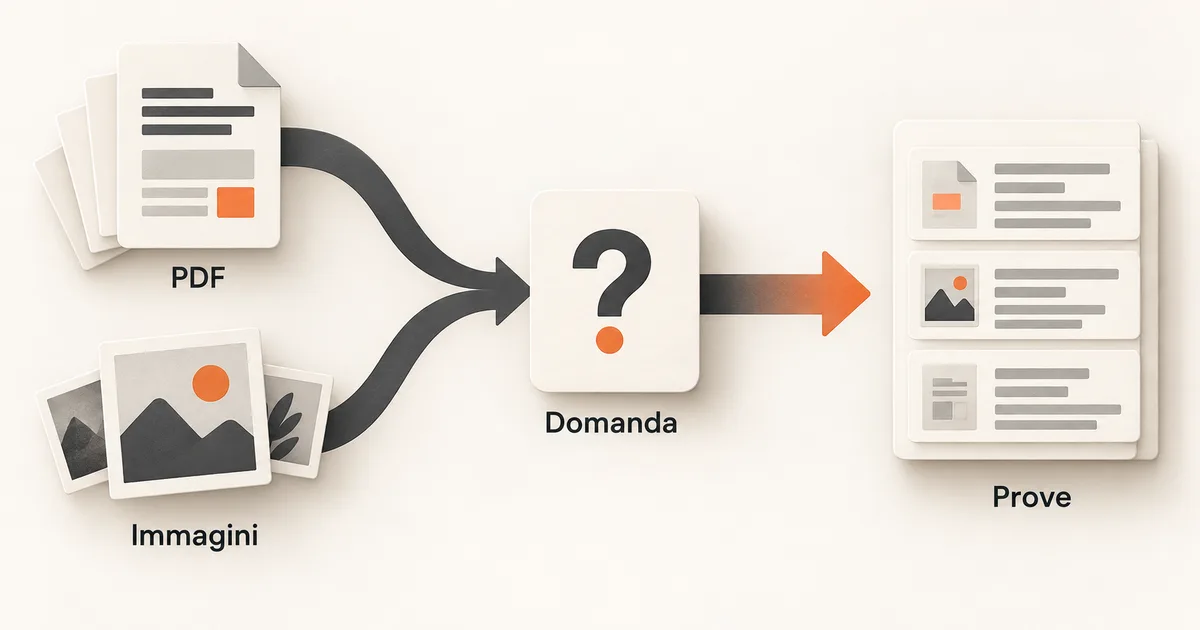
Il RAG rende disponibile al modello una memoria esterna recuperabile. Il paper che ha introdotto il termine mette in evidenza proprio due esigenze: aggiornare la conoscenza e risalire alla provenienza. Per soddisfarle, il lavoro più importante avviene prima del prompt.
Definisci il lavoro della collezione
Parti dalle domande che l'assistente deve sostenere e dalle decisioni che non deve prendere. Documentazione aziendale non è un perimetro. Procedure approvate per installazione e assistenza dei prodotti venduti in Italia lo è.
Scrivi un contratto del corpus:
collection: support-procedures-it
purpose: rispondere su installazione e assistenza standard
included:
  - procedure approvate dal knowledge owner
  - manuali prodotto correnti
excluded:
  - bozze
  - email individuali
  - eccezioni contrattuali
  - documenti scaduti
answer_policy:
  conflict: abstain_and_escalate
  missing_source: abstain
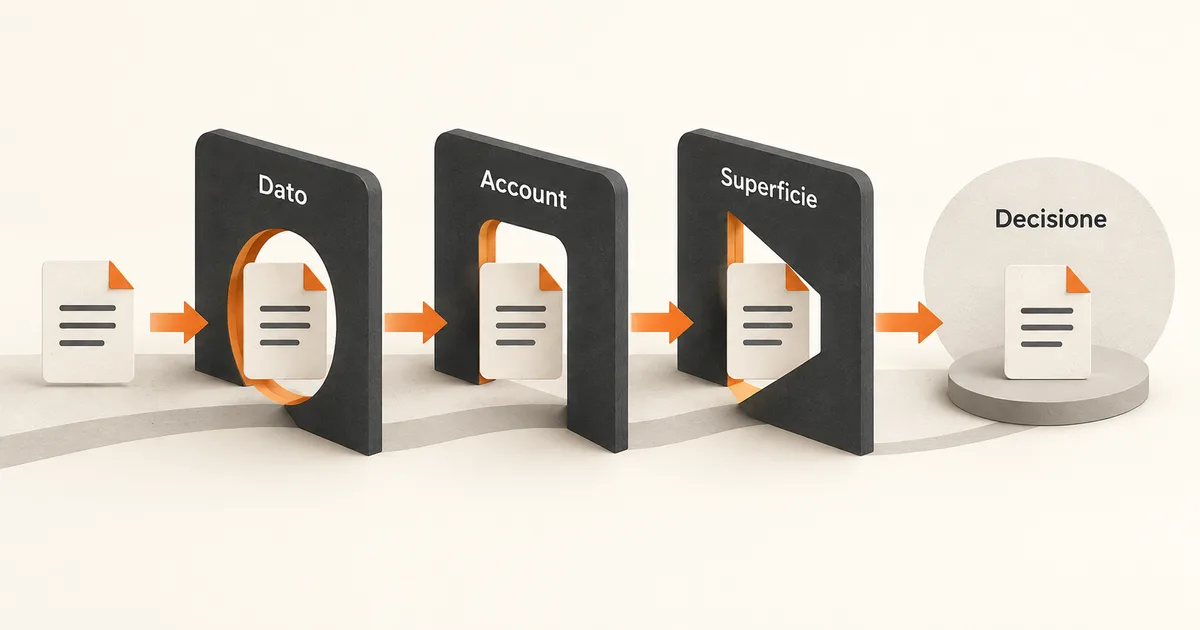
Il contratto di input di un workflow AI aiuta a definire formato, provenienza e condizioni di rifiuto. Applicato al corpus, impedisce che ogni file leggibile diventi automaticamente conoscenza autorizzata.
Nomina un owner del contenuto e uno tecnico. Il primo decide se una fonte è valida e quale prevale. Il secondo garantisce acquisizione, indice, accessi e ricevute. Se queste autorità restano implicite, un problema documentale finirà trattato come un problema del modello.
Dai a ogni fonte identità, autorità e validità
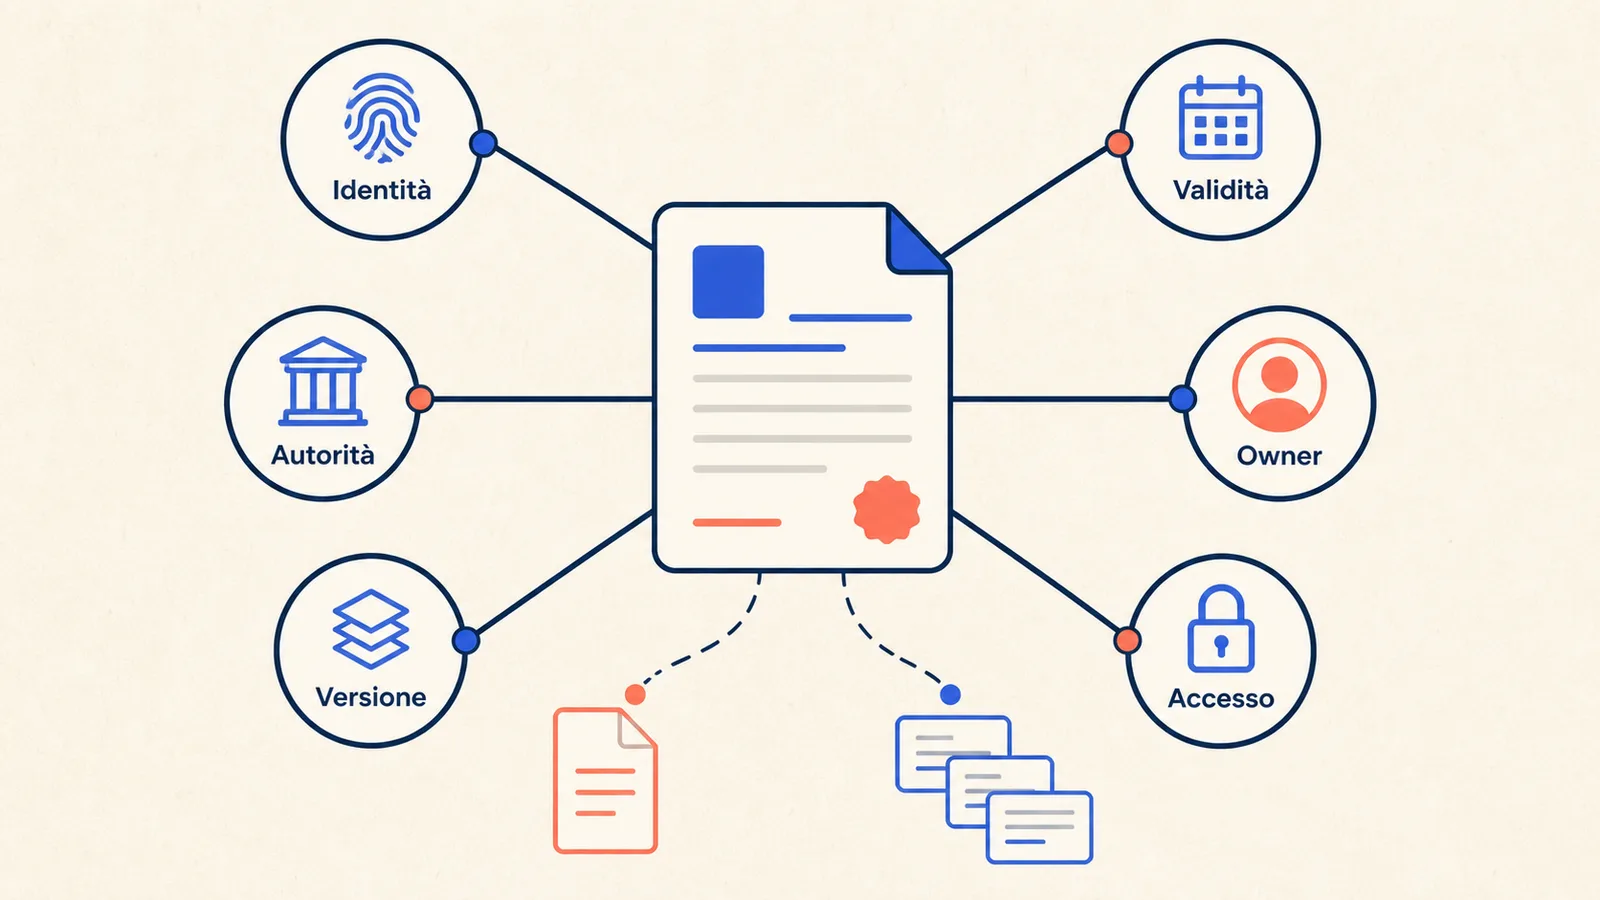
Ogni documento ammesso deve avere un record stabile prima di essere diviso in chunk. Il percorso del file non è un'identità sufficiente: può cambiare, duplicarsi o perdere il contesto.
Un record minimo può contenere:
Campo | Esempio | Funzione |
|---|---|---|
|
| identità stabile |
| Installazione prodotto A | titolo leggibile |
| procedure_approved | livello di autorità |
| product-operations | ruolo responsabile |
|
| versione dichiarata |
|
| inizio validità |
|
| fine validità, se nota |
|
| relazione con la versione precedente |
|
| prova del contenuto acquisito |
| internal-support | filtro di accesso |
L'autorità non è sinonimo di popolarità. Una pagina visitata spesso può essere vecchia. Una nota recente può descrivere un'eccezione ma non sostituire la procedura. Definisci una precedenza esplicita e lascia che il sistema segnali il conflitto invece di scegliere il documento con lo score vettoriale più alto.
Microsoft indica che ID, titolo, sintesi e metadata dipendenti dal dominio possono sostenere ricerca, filtri e rintracciabilità. Aggiungi solo ciò che serve al recupero, all'accesso o alla verifica. Un metadata non mantenuto crea un nuovo modo di sbagliare.
Acquisisci il documento senza perdere la struttura
Il parsing trasforma il file, ma deve preservare i segnali che ne spiegano il significato: titoli, sezioni, tabelle, note, numerazione, didascalie e relazione fra testo e allegati.
Prima di indicizzare, conserva tre livelli:
sorgente originale immutabile o riferimento verificabile
rappresentazione estratta con log degli errori
chunk arricchiti destinati all'indice
Se un PDF scansionato perde una tabella, il chunk può sembrare grammaticalmente corretto e tuttavia essere falso per omissione. Registra warning di OCR, pagine vuote, colonne spezzate e allegati mancanti. Un documento che non supera il parsing può restare quarantined invece di entrare in produzione.
Il risultato deve permettere la risalita: risposta, chunk, sezione, documento, versione e owner. L'audit trail di un workflow AI mostra come mantenere eventi e ricevute senza trasformare il log in una copia indiscriminata dei dati.
Progetta metadata utili al recupero
I metadata hanno almeno quattro scopi diversi:
filtrare ciò che l'utente è autorizzato a vedere
restringere per prodotto, paese, lingua o periodo
mostrare una citazione comprensibile
riconciliare versioni e rimozioni
Non usare un unico campo libero per tutto. Distingui valori controllati da testo descrittivo. country: IT è filtrabile; valido soprattutto per l'Italia è ambiguo.
Per ogni chunk conserva l'identità del padre e la posizione:
{
  "chunk_id": "proc-install-017:v3.2:s04:c02",
  "source_id": "proc-install-017",
  "source_version": "3.2",
  "section_path": ["Installazione", "Controlli iniziali"],
  "page": 7,
  "authority": "procedure_approved",
  "language": "it",
  "valid_from": "2026-08-15",
  "access_class": "internal-support"
}
Non mettere dati personali o segreti nei metadata per comodità. Sono parte dell'indice e possono comparire in log, dashboard e strumenti di analisi. Applica gli stessi controlli della sorgente.
Sperimenta il chunking sulle domande vere
La dimensione ideale non esiste fuori dal corpus. Una FAQ, un contratto e un manuale tecnico hanno strutture diverse. Microsoft raccomanda di scegliere il metodo in base al tipo di documento e di sperimentare sul proprio caso.
Confronta almeno due strategie su un set di domande con documento atteso:
chunk per heading e paragrafo, con piccola sovrapposizione
chunk semantici che mantengono insieme passaggi correlati
parent-child, con unità piccola per il recupero e contesto più ampio per la risposta
trattamento specifico per tabelle, liste e procedure numerate
Misura se il documento corretto entra fra i risultati utili, se il passaggio contiene abbastanza contesto e se la citazione rimane precisa. Un chunk enorme può recuperare il documento giusto ma diluire la risposta. Uno troppo piccolo può separare una condizione dalla sua eccezione.
Il test dovrebbe includere domande facili, parafrasi, lessico dell'utente, casi negativi e fonti in conflitto. Mantieni fissi embedding, filtri e reranker mentre confronti il solo chunking, altrimenti non sai quale scelta ha cambiato il risultato.
Pubblica una versione dell'indice
Non aggiornare l'indice attivo documento per documento senza sapere quale insieme stai servendo. Prepara una versione candidata della collezione, esegui i controlli e poi promuovila.
Una ricevuta di pubblicazione può indicare:
collection_release: support-procedures-it-2026-09-01.1
source_manifest_hash: sha256:...
sources_admitted: 184
sources_rejected: 3
chunks_created: 2187
embedding_model: embedding-family-version
chunking_policy: heading-parent-child-v4
evaluation_run: rag-retrieval-2026-09-01-02
previous_release: support-procedures-it-2026-08-24.1
Le quantità documentano il rilascio, non ne provano la qualità. Il gate deve leggere i casi e i rischi: fonti scadute recuperate, documenti attesi mancanti, conflitti non rilevati, accessi violati e citazioni non rintracciabili.
Conserva la versione precedente finché il ritorno non è stato provato. Se l'indice nuovo sbaglia, il team deve poter ripristinare una collezione conosciuta senza ricostruirla durante l'incidente.
Aggiorna e rimuovi con una ricevuta
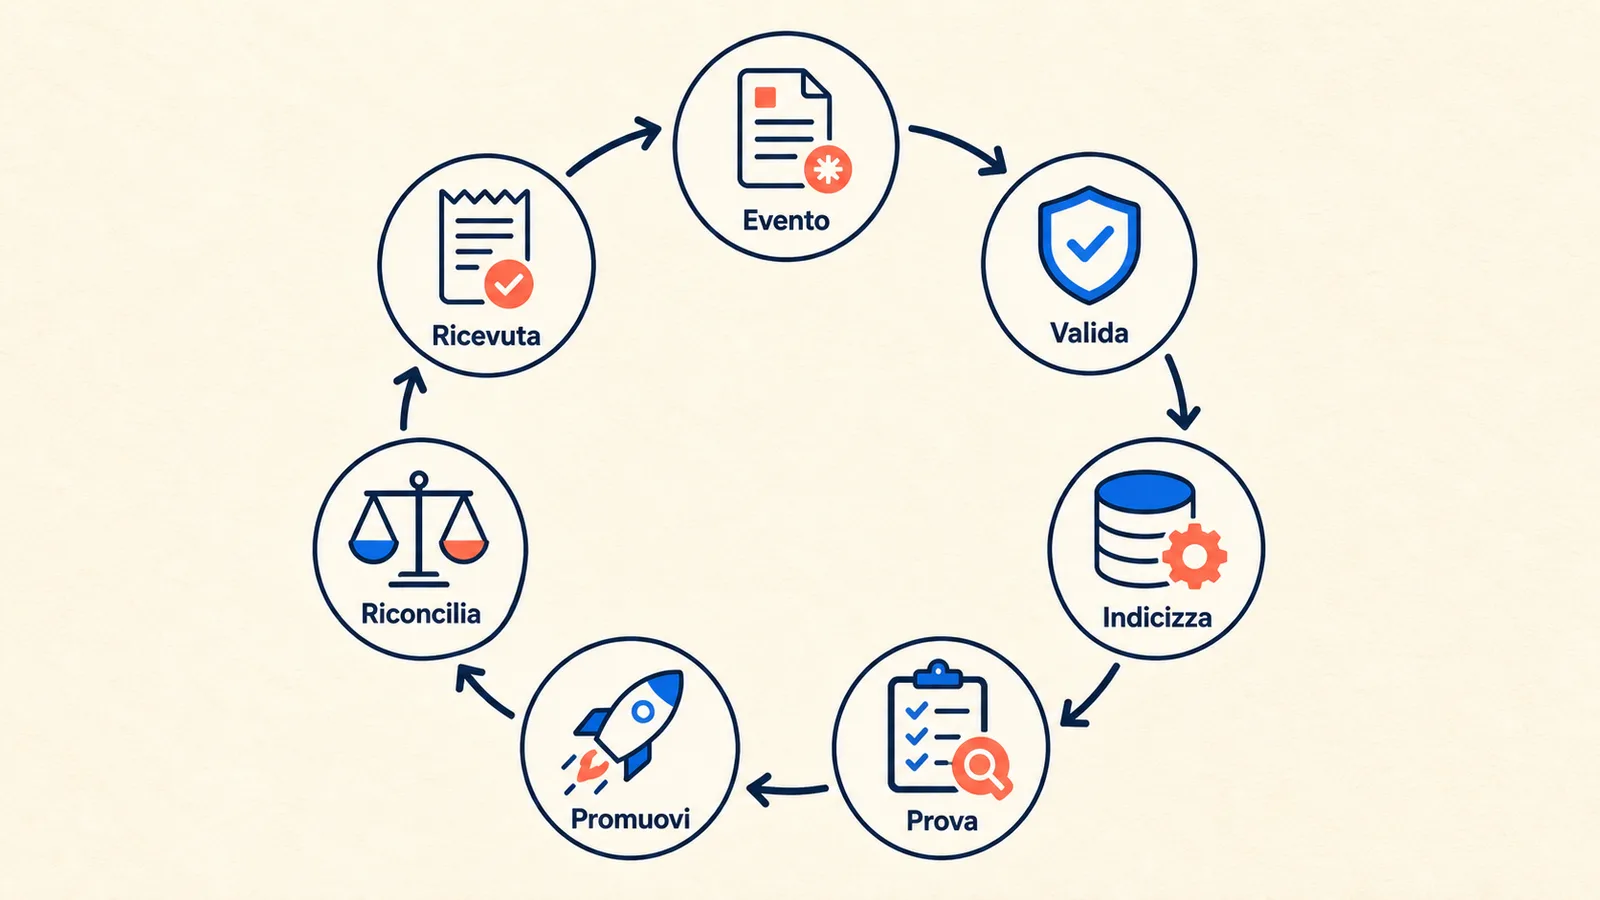
L'aggiornamento non termina quando il nuovo file entra. Termina quando la versione sostituita non è più recuperabile dove non deve esserlo e i riferimenti restano coerenti.
Usa un ciclo esplicito:
evento sorgente
  -> valida autorità e versione
  -> acquisisci e confronta hash
  -> crea indice candidato
  -> prova domande e accessi
  -> promuovi release
  -> riconcilia vecchi chunk
  -> emetti ricevuta
Per una rimozione, cerca tutti i chunk legati a source_id e versione. Verifica cache, repliche e indici secondari. Il comando riuscito non è ancora la prova: serve una query di riconciliazione che mostri che il contenuto non viene più restituito.
Per una correzione, non sovrascrivere l'identità senza traccia. Crea la nuova versione, indica quale sostituisce e conserva la relazione. Le risposte storiche potranno così essere interpretate nel contesto della collezione usata allora.
Microsoft include la strategia di aggiornamento e il version control dei documenti fra le parti dell'ingestion RAG. È un requisito operativo: una knowledge base che sa aggiungere ma non sa sostituire e rimuovere accumula contraddizioni.
Tratta il conflitto come un dato
Due fonti ammesse possono contraddirsi. Evita di chiedere al modello di scegliere la più convincente. Definisci la regola:
una versione dichiarata come successiva prevale sulla precedente
una fonte con autorità maggiore prevale soltanto nel proprio perimetro
due fonti correnti con pari autorità producono astensione ed escalation
una fonte fuori validità non entra nella risposta corrente
Mostra all'owner titolo, versione, passaggi e relazione fra le fonti. Il conflitto è un problema di knowledge management prima che di generazione.
Registra la risoluzione come nuovo fatto nel source registry. Evita eccezioni nascoste nel prompt: diventano invisibili a chi mantiene i documenti e fragili al prossimo aggiornamento.
Esempio fittizio
Un assistente supporta tecnici che installano due famiglie di dispositivi. Il corpus iniziale contiene manuali correnti, FAQ, tre procedure e una cartella di comunicazioni interne. Una domanda sui controlli elettrici recupera una mail recente che contraddice il manuale approvato.
Il team non alza il peso del manuale nel prompt. Rimuove le email dal perimetro, assegna authority alle fonti ammesse e crea una procedura per le eccezioni. Ogni chunk riceve source_id, versione, sezione, prodotto e validità.
Nei test, i chunk per lunghezza separano un avviso dal passaggio successivo. La strategia per heading li mantiene insieme e migliora il recupero sui casi attesi. Il team pubblica una release candidata, verifica le domande negative e prova la rimozione della vecchia procedura.
Quando arriva la versione 4.0, l'indice nuovo sostituisce la 3.2 e la riconciliazione conferma che nessun chunk della versione scaduta compare nelle query correnti. La ricevuta collega sorgenti, policy, test e release.
Think, Build, Enable applicato alla knowledge base
Think: definisci domande, fonti ammesse, autorità, accessi, validità, conflitti e owner prima di scegliere database o embedding.
Build: crea source registry, parsing controllato, metadata, esperimenti di chunking e una release candidata dell'indice con test di recupero.
Enable: consegna agli owner il flusso di ammissione, aggiornamento e rimozione; forma chi usa l'assistente a leggere citazioni e segnalare conflitti.
Porta corpus, domande e documenti in conflitto a MAIKER HUB per progettare chatbot e assistenti AI. Una buona knowledge base non promette che il modello sappia tutto. Rende verificabile quale conoscenza era disponibile, con quale autorità e in quale versione.
Domande frequenti
Posso indicizzare tutta la cartella condivisa?
Solo se ogni contenuto rispetta perimetro, autorità, accessi e validità. La disponibilità tecnica di un file non equivale all'autorizzazione a usarlo come fonte.
Qual è la dimensione migliore dei chunk?
Dipende da struttura, domande e retrieval. Confronta strategie su casi rappresentativi e misura recupero, contesto e precisione della citazione.
Devo conservare il documento originale?
Devi poter risalire alla fonte verificabile e alla versione usata. Modalità e durata dipendono da obblighi documentali, privacy, licenze e architettura.
Come gestisco due documenti in conflitto?
Applica una regola di autorità e validità già definita. Se il conflitto resta fra fonti correnti equivalenti, l'assistente si astiene e passa il caso al knowledge owner.
Come verifico che una fonte sia stata rimossa?
Riconcilia tutti i chunk legati alla sua identità, controlla indici e cache e prova query che prima la recuperavano. Conserva una ricevuta del risultato.