Come governare l'auto memory di Claude Code progetto per progetto
L'auto memory permette a Claude Code di annotare pattern utili fra una sessione e l'altra: comandi di build, preferenze, convenzioni o soluzioni già scoperte. Può ridurre ripetizioni, ma non trasforma quelle note in policy, documentazione approvata o fonte canonica.
Per usarla bene devi decidere dove vive ogni informazione. Le regole che vuoi imporre vanno in CLAUDE.md o in controlli tecnici; le decisioni con data e responsabilità restano nei file del progetto; la memoria raccoglie apprendimenti operativi da rileggere e correggere. Il valore non sta nel ricordare tutto, ma nel mantenere visibile la differenza fra istruzione, nota e prova.
Auto memory e CLAUDE.md hanno responsabilità diverse
La documentazione di Claude Code descrive due meccanismi complementari. CLAUDE.md contiene istruzioni scritte da te: convenzioni, comandi, struttura del repository e regole che vuoi presentare in ogni sessione. L'auto memory contiene note che Claude decide di salvare perché potrebbero essere utili in futuro.
Questa differenza di autore cambia la responsabilità. Una regola come “esegui il test di migrazione prima di cambiare lo schema” non dovrebbe esistere soltanto in una nota automatica. Va nel documento che governa il lavoro e, se la conseguenza è importante, anche nel controllo che può bloccare una violazione.
Una scoperta come “il test X richiede il servizio locale Y” può invece stare in memoria, purché sia verificata e non contenga segreti. Se diventa una dipendenza stabile per tutto il team, promuovila nella documentazione del progetto.
L'auto memory è contesto. Claude può usarla, ma non offre la stessa forza di un test, una policy gestita o un permesso del sistema operativo.
Decidi dove vive ogni informazione
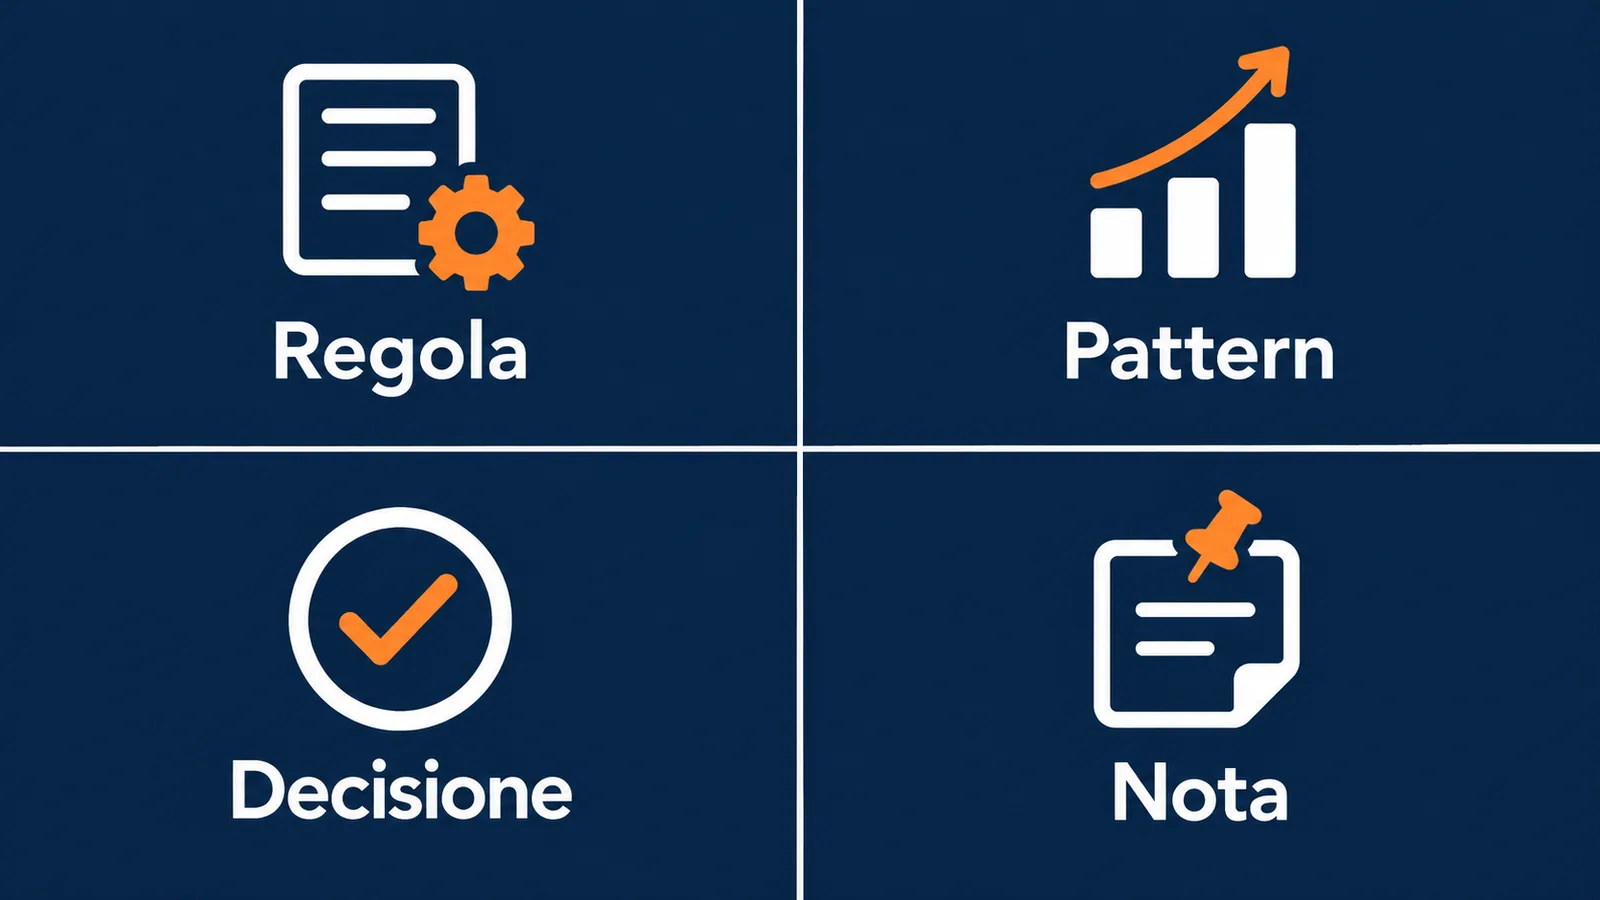
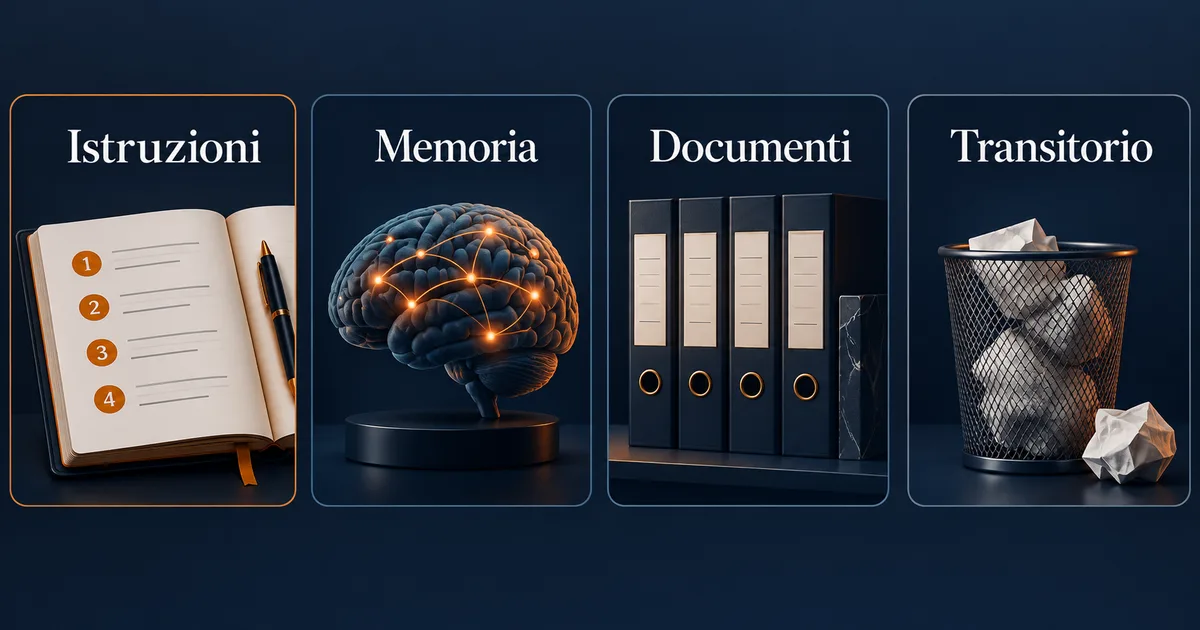
Usa quattro destinazioni.
Destinazione | Che cosa contiene | Esempio sintetico |
|---|---|---|
| istruzioni che devono accompagnare ogni sessione | “usa |
Auto memory | pattern scoperti e suggerimenti operativi | “il fixture delle date vive in |
Documento canonico | decisioni, procedure, fonti e stato con versione | “migrazione approvata il giorno X” |
Transitorio | ipotesi e dettagli utili soltanto al task corrente | “la causa potrebbe essere il parser” |
Prima di salvare o promuovere un'informazione, chiedi:
deve essere seguita o soltanto ricordata?
serve a tutte le sessioni o a un caso specifico?
richiede data, fonte, approvazione o storico?
contiene dati che non devono entrare in una memoria automatica?
Se deve essere seguita, scrivila come istruzione e rendila testabile. Se richiede storico, mettila nel documento canonico. Se è un'ipotesi non provata, lasciala nel task fino alla verifica. La memoria è appropriata quando una nota operativa verificata rende più rapido un futuro incarico senza diventare l'unica copia di una decisione.
Ispeziona ciò che Claude ha salvato
Il comando /memory permette di vedere i file di istruzioni caricati e aprire la cartella dell'auto memory. I file sono Markdown leggibili e modificabili. Non aspettare un errore per guardarli: una revisione breve scopre note troppo generiche, obsolete o derivate da un caso eccezionale.
Per ogni voce controlla:
origine: deriva da un comando riuscito, da una correzione o da un'inferenza?
scope: vale per tutto il repository o per una sottocartella?
freschezza: la dipendenza o il percorso esiste ancora?
autorità: è un fatto tecnico, una preferenza o una decisione non approvata?
sensibilità: contiene percorsi personali, token, dati cliente o dettagli inutili?
Correggi la formulazione, non soltanto l'errore. “I test falliscono senza Redis” è ambiguo se vale soltanto per una suite. “La suite integration/cache richiede Redis locale; verificato con comando X” è più limitata e controllabile.
Se una nota non ha una fonte o un modo semplice per essere ricontrollata, riducila a ipotesi oppure rimuovila. Una memoria piena di certezze non verificabili rende la sessione apparentemente fluida e realmente fragile.
Riduci MEMORY.md a un indice utile
Claude Code carica all'avvio i primi 200 righi o 25 KB di MEMORY.md, a seconda del limite raggiunto per primo. I file tematici possono contenere dettagli e vengono letti quando servono. Questo suggerisce una struttura: l'entrypoint deve orientare, non diventare un archivio infinito.
Mantieni in MEMORY.md:
un elenco breve dei temi disponibili;
i pattern più ricorrenti e ancora validi;
i link ai file tematici;
eventuali date di verifica quando la freschezza conta.
Sposta i dettagli in file come debugging.md, build.md o test-patterns.md. Il nome descrive il contenuto; non usare misc.md come contenitore senza ownership. Una nota tematica dovrebbe indicare il perimetro e, quando possibile, il comando che ne conferma l'utilità.
Il limite di caricamento non è un invito a riempire i primi 200 righi. Più contesto permanente aggiungi, più aumenta la concorrenza con il task corrente. Un indice piccolo aiuta Claude a recuperare il dettaglio soltanto quando serve.
Verifica scope e portabilità
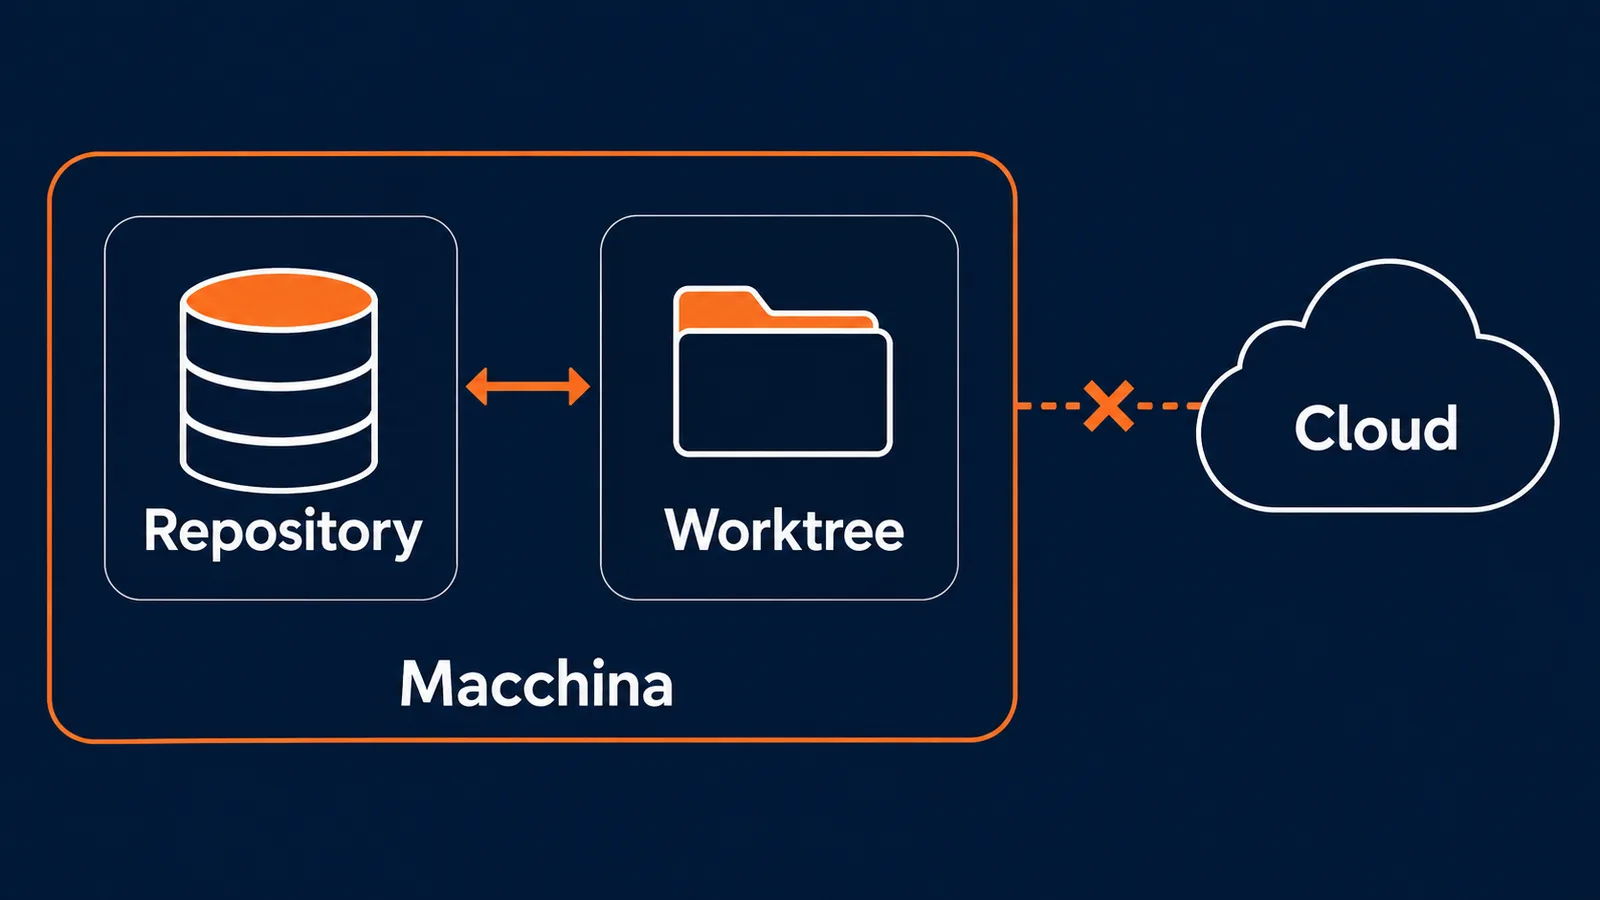
L'auto memory è associata al repository. Worktree e sottocartelle dello stesso repository condividono la stessa directory di memoria. Questo facilita la continuità, ma richiede attenzione: una nota scoperta in un worktree sperimentale può comparire anche in una sessione sul branch principale.
Prima di memorizzarla, chiediti se vale per tutte le varianti del repository. Se un comando riguarda soltanto un branch o una migrazione temporanea, dichiaralo nel testo e assegna una scadenza o una condizione di rimozione.
La memoria è inoltre locale alla macchina. Non viene condivisa automaticamente con un altro computer o con gli ambienti cloud. Se un collega o una sessione remota deve conoscere una regola, mettila nel repository o nel sistema documentale appropriato. Non concludere che “Claude lo sa” perché la tua macchina lo ricorda.
Questa distinzione evita due errori opposti: aspettarsi una sincronizzazione che non esiste e copiare alla cieca note locali dentro il progetto. Prima di rendere portabile una nota, controlla privacy, utilità per il team e stabilità.
Prova anche ciò che non deve essere ricordato
Un audit non verifica soltanto che una nota utile venga richiamata. Deve controllare anche che informazioni escluse non influenzino il lavoro.
Prepara una prova positiva e una negativa:
positiva: chiedi come eseguire una suite che la memoria documenta e confronta la risposta con il comando verificato;
negativa: formula un task simile in una sottocartella esclusa e controlla che Claude non applichi la regola fuori scope.
Per una nota rimossa, avvia una nuova sessione e verifica che non venga presentata come memoria disponibile. Non usare il test negativo come garanzia assoluta: serve a scoprire subito persistenze e scope errati. Per segreti o dati ad alto rischio, la misura sicura resta non inserirli.
Registra l'esito come Atteso, Osservato, Differenza e Azione. Se Claude applica una nota nel posto sbagliato, correggi lo scope della memoria o promuovi una regola più precisa in un file path-specific.
Correggi senza perdere la fonte canonica
Quando una nota di memoria contraddice un documento approvato, prevale la fonte canonica. Aggiorna o rimuovi la nota e conserva nel documento la storia della decisione. Non riscrivere il file canonico per farlo coincidere con una memoria automatica.
Se la stessa correzione ricorre, chiediti se il problema è di memoria o di governance. Una convenzione ripetutamente violata merita un'istruzione più chiara, un test o un lint. Una nota che aiuta a trovare un comando raro può restare memoria. Non chiedere al contesto di applicare un vincolo che il sistema può verificare in modo deterministico.
Nel percorso Second Brain con Claude Cowork e Code i file conservano procedure, decisioni e stato. L'auto memory aggiunge comodità locale: accelera il richiamo, ma il lavoro resta portabile anche quando cambi macchina, ambiente o assistente.
Domande frequenti
Auto memory e memoria dell'account Claude sono la stessa cosa?
No. Qui si parla dell'auto memory locale di Claude Code, associata a un repository. La memoria dell'account e i suoi flussi di importazione o esportazione sono una superficie diversa.
La memoria viene condivisa fra worktree?
Sì, la documentazione indica che worktree e sottocartelle dello stesso repository condividono l'auto memory. Per questo lo scope delle note deve essere esplicito.
Posso modificare ciò che Claude ha salvato?
Sì. I file sono Markdown e /memory permette di individuarli e aprirli. Puoi correggere o rimuovere note obsolete.
Le note passano automaticamente a un ambiente cloud?
No. La documentazione le descrive come locali alla macchina. Le informazioni che devono viaggiare vanno in file portabili e governati.