Come aggiornare un modello AI in produzione
Cambiare il nome del modello in una variabile d'ambiente richiede pochi minuti. Dimostrare che il workflow continua a fare il lavoro previsto richiede un rilascio.
La differenza conta perché il comportamento non dipende dal modello soltanto. Prompt, tool, retrieval, filtri, parametri, permessi e dati di contesto formano un sistema. Se cambi tre elementi insieme e il risultato migliora, non sai quale modifica lo ha prodotto. Se peggiora, non sai quale ripristinare.
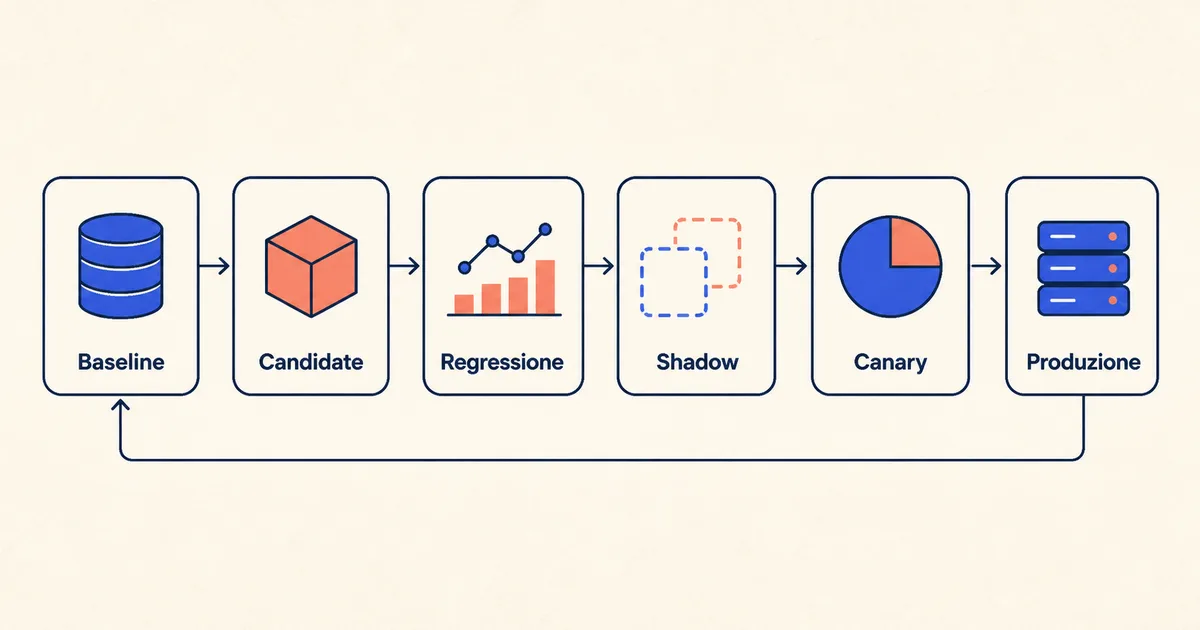
Un aggiornamento controllato segue una sequenza leggibile: congela la baseline, registra la candidate, esegue gli stessi casi più volte, osserva senza impatto quando possibile, espone una quota limitata, valuta i gate e conserva il ritorno alla versione precedente.
Definisci l'unità che stai cambiando
Prima di confrontare due modelli, scrivi che cosa resta fisso. La versione da rilasciare dovrebbe identificare almeno:
release_id: assistant-support-2026-09-01-candidate
model: provider/family/version
system_prompt_hash: sha256:...
tool_manifest: tools-v7
retrieval_index: procedures-2026-08-31
policy_bundle: support-policy-v4
parameters:
  temperature: 0.2
  max_output_tokens: 1200
Questo manifest evita una falsa attribuzione. Un output più preciso potrebbe dipendere dal nuovo corpus, non dal nuovo modello. Una chiamata tool fallita potrebbe nascere da uno schema modificato. Il nome commerciale del modello, da solo, non basta a ricostruire il test.
Il controllo delle modifiche nei workflow AI offre il quadro generale per richiesta, approvazione e ricevuta. Nel cambio modello il record deve aggiungere una comparazione diretta fra configurazione corrente e candidata.
Congela la baseline prima del confronto
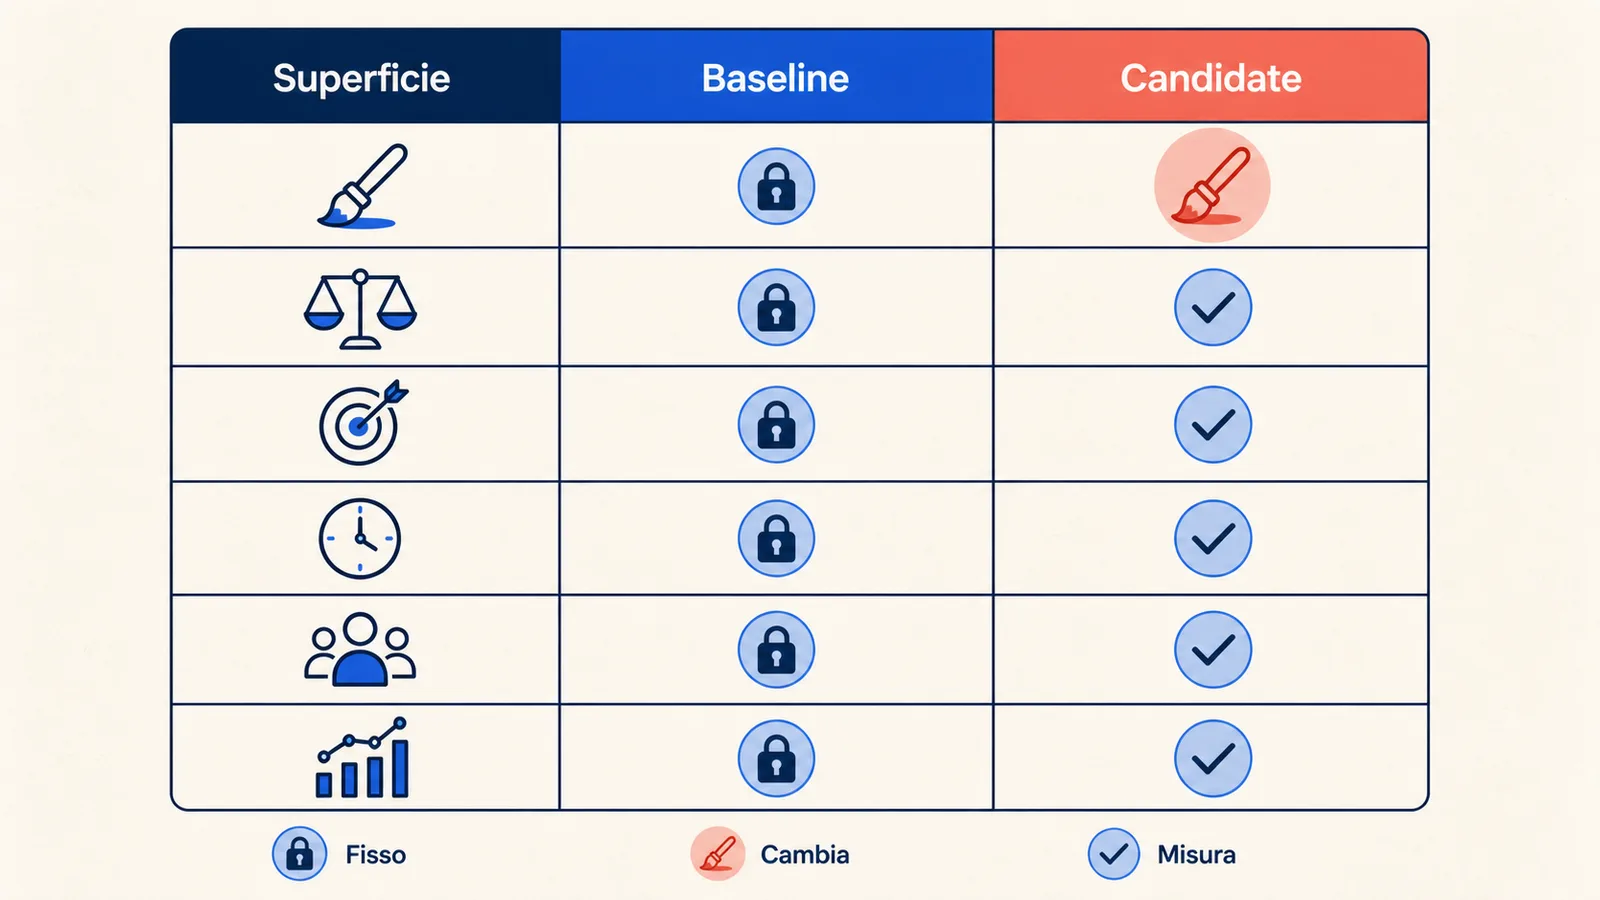
La baseline è la versione che oggi sostiene il processo, compresi i suoi difetti noti. Congelarla significa salvare manifest, dataset, regole di scoring e risultati prima di lanciare la candidate.
Usa una matrice piccola:
Superficie | Baseline | Candidate | Regola |
|---|---|---|---|
modello | versione corrente | nuova versione | unica variabile intenzionale |
prompt | hash P14 | hash P14 | fisso |
tool | manifest T7 | manifest T7 | fisso |
indice | KB 31 agosto | KB 31 agosto | fisso |
casi | suite R12 | suite R12 | identica |
scorer | rubrica S5 | rubrica S5 | identico |
Se il provider ritira la baseline o modifica un alias non fissato, annota l'incertezza. Non chiamare confronto una prova che non può più riprodurre il comportamento precedente.
Il registry aiuta a dare identità alle versioni. MLflow, per esempio, associa versioni a source run, timestamp, signature, tag e alias. Puoi usare nomi diversi, ma devi conservare gli stessi fatti: provenienza, configurazione, ruolo nel rilascio e momento della decisione.
Costruisci la regressione dal rischio reale
La suite non è una raccolta di prompt gradevoli. Deve contenere il lavoro comune, i bordi e i fallimenti che il team non vuole rivedere.
Dividila almeno in quattro gruppi:
casi frequenti che definiscono il valore quotidiano
casi difficili con input incompleti, ambigui o lunghi
casi negativi in cui il sistema deve rifiutare o passare la richiesta
incidenti storici trasformati in test ripetibili
Per un workflow con tool, misura anche scelta dell'azione, argomenti, ordine, timeout e gestione dell'errore. Per un assistente RAG, controlla documento atteso, citazione e astensione quando la fonte manca. Per un classificatore, guarda gli errori per classe e non soltanto la media.
Il dataset di test per un workflow AI serve a costruire casi con input, risultato atteso, rischio e provenienza. Nel cambio modello quel dataset diventa il terreno comune della comparazione.
Non inventare una soglia universale. Decidi quali regressioni bloccano il rilascio e quali possono essere accettate dal process owner. Un miglioramento nel tono non compensa una nuova azione non autorizzata.
Ripeti i casi e conserva la distribuzione
Un solo passaggio per caso nasconde la variabilità. Ripeti i test quando la generazione non è deterministica e registra la distribuzione degli esiti.
Per ogni caso puoi conservare:
baseline: 5 esecuzioni, 5 corrette, latenza p50 1,8 s
candidate: 5 esecuzioni, 4 corrette, 1 escalation mancata, latenza p50 1,5 s
decisione: bloccata per escalation mancata
Non serve moltiplicare ogni prova senza criterio. Aumenta le ripetizioni sui casi instabili, sulle azioni e sugli esiti ad alto impatto. Conserva output grezzi, valutazioni e versione dello scorer, così un disaccordo può essere riesaminato.
Valuta dimensioni separate: correttezza del compito, rispetto dei confini, stabilità, errori tool, latenza e costo. Una media unica rende invisibile quale qualità stai scambiando con quale rischio.
Osserva la candidate senza darle autorità
Lo shadow mode invia alla candidate una copia degli input reali, quando privacy e architettura lo consentono, ma continua a usare la baseline per il processo. La risposta candidata resta fuori dal percorso operativo.
Serve a vedere distribuzioni che la suite non contiene: lingue rare, allegati insoliti, richieste stagionali, lunghezze inattese. Non equivale a un test privo di rischio. Copiare input verso un nuovo provider o ambiente può cambiare trattamento dei dati, logging e retention. L'accesso va autorizzato prima.
Durante lo shadow confronta comportamenti osservabili e non la semplice somiglianza testuale. Due risposte diverse possono essere entrambe valide. Due risposte quasi uguali possono divergere proprio sull'azione che conta.
Segna gli input che rivelano un buco nella suite, anonimizzali quando necessario e trasformali in nuovi casi. La fase serve a migliorare la prova, non a raccogliere dati senza limite.
Promuovi per stadi e conserva il ritorno
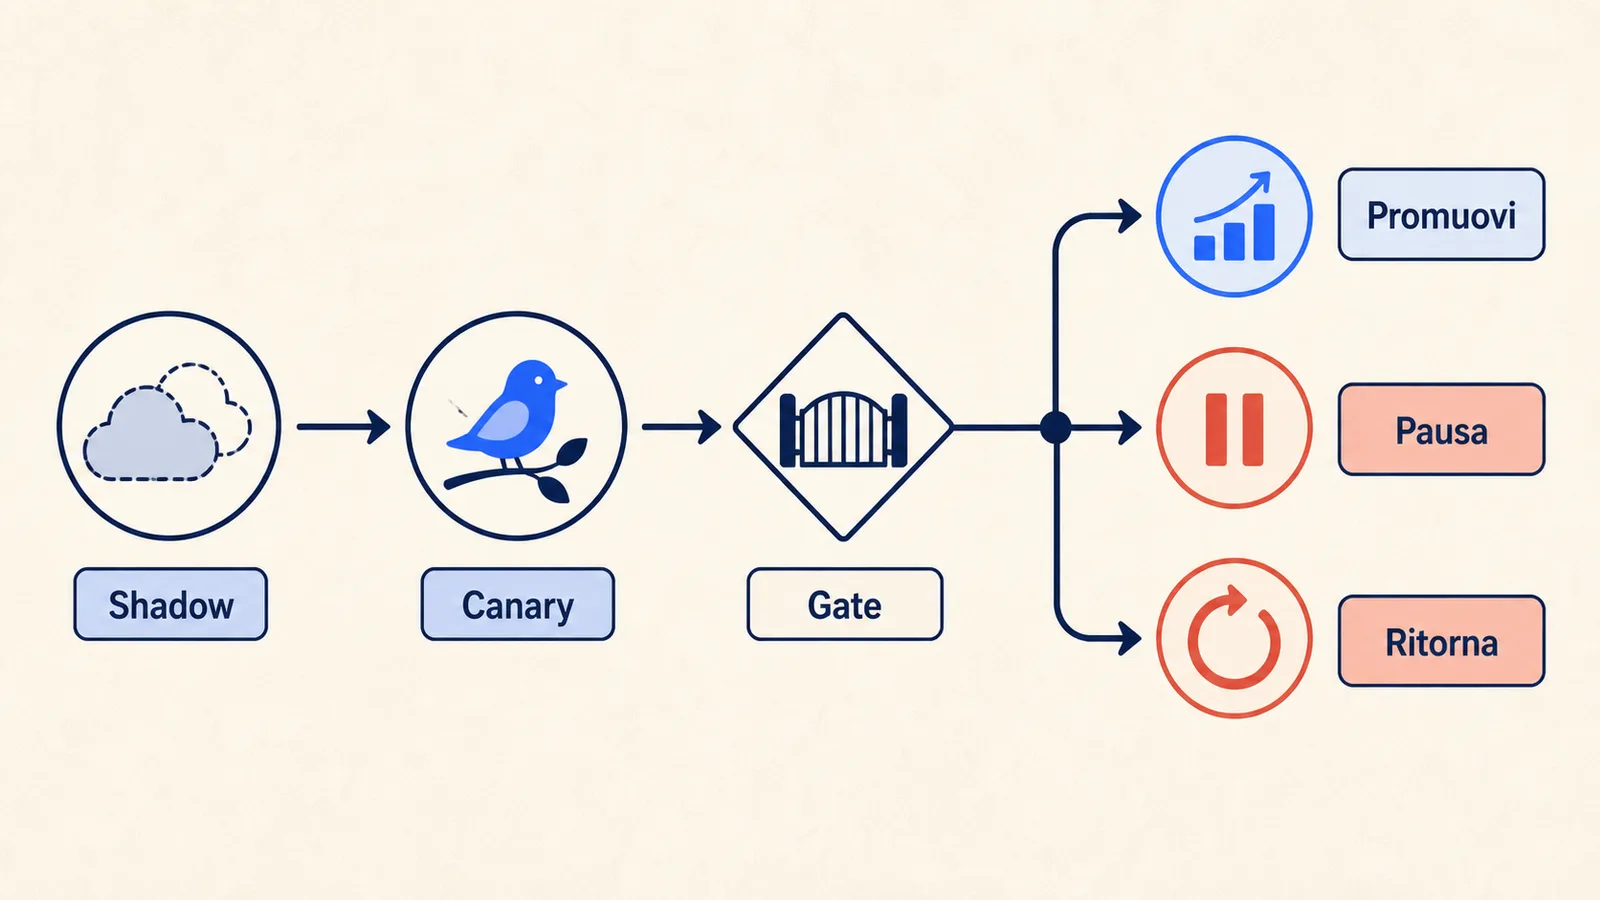
Quando regressione e shadow sono verdi, assegna alla candidate una quota controllata. Google SRE definisce il canary come un rilascio parziale, osservato per un periodo e confrontato con un controllo prima di estenderlo.
Nel workflow AI il gate può essere:
candidate pronta
  -> 5% traffico interno
  -> gate su errori bloccanti, tool, latenza e costo
  -> 20% con review
  -> gate del process owner
  -> promozione oppure ritorno alla baseline
La quota è un esempio, non una prescrizione. Un processo ad alto impatto può richiedere un pilota chiuso senza utenti esterni. Un assistente interno a basso impatto può tollerare un canary più ampio. Il punto è limitare il raggio del cambiamento e definire in anticipo chi legge i segnali.
Gli alias candidate e champion, descritti nel workflow di MLflow, sono utili perché separano il ruolo dalla versione. Spostare un alias non deve però cancellare il record: conserva chi lo ha spostato, da quale versione a quale, con quale prova e quale ricevuta.
Il fallback deve essere provato prima del canary. Il fallback manuale di un workflow AI chiarisce come mantenere il lavoro essenziale quando l'automazione si ferma. Nel cambio modello hai due ritorni distinti: alla versione tecnica precedente e al processo umano se anche quella non è disponibile.
Scrivi i gate prima di vedere i risultati
Decidere dopo il test invita a spostare l'asticella. Registra prima:
errori che bloccano sempre la promozione
degradi ammessi e relativa autorità decisionale
finestra di osservazione
segnali che impongono pausa o ritorno
owner tecnico e owner di processo
modalità di comunicazione dell'incidente
Un gate può dire: zero invii senza conferma nei casi negativi; nessuna regressione sui 12 incidenti storici; latenza entro il limite operativo approvato; costo stimato entro il budget del workflow.
Evita candidate migliore. Scrivi candidate promossa perché passa i gate G1-G6 sulla suite R12 e non mostra regressioni bloccanti nel canary C3.
Conserva un decision record breve
Alla fine serve una ricevuta leggibile:
decision: promote
baseline: release-42
candidate: release-47
evidence:
  regression_run: reg-2026-09-01-03
  shadow_window: shadow-08-25_08-29
  canary: canary-47b
accepted_tradeoffs:
  - latenza p95 più alta entro il limite approvato
blocking_regressions: []
fallback_verified: true
approved_by:
  - ai-platform-owner
  - support-process-owner
Il profilo NIST GenAI richiama la valutazione empirica dei claim e la condivisione dei risultati pre-deployment con chi autorizza il rilascio. Il record rende quella decisione controllabile. Non sostituisce il giudizio: gli dà un oggetto comune.
Esempio fittizio
Un assistente classifica richieste e prepara bozze per il supporto. La candidate riduce il tempo medio e scrive risposte più chiare. Nella regressione, però, uno dei casi storici di identità incerta viene classificato come richiesta ordinaria invece di passare al team competente.
Il team non compensa l'errore con il punteggio medio. Blocca la promozione, aggiunge esempi dello stesso rischio e verifica se il problema nasce dal modello o da un'istruzione interpretata diversamente.
La seconda candidate passa i casi critici. In shadow emergono richieste miste in due lingue, assenti dal dataset. Vengono aggiunte alla suite. Il canary resta limitato agli operatori interni, con review obbligatoria sulle azioni. Dopo la finestra decisa, gli owner spostano l'alias champion e conservano baseline e ricevuta di ritorno.
Il risultato non è abbiamo adottato il modello nuovo. È sappiamo quale versione sostiene il processo, perché è stata promossa e come tornare indietro.
Think, Build, Enable applicato al cambio modello
Think: identifica rischio, unità di rilascio, casi bloccanti, autorità e segnali prima di confrontare i risultati.
Build: congela baseline e suite, registra la candidate, ripeti i test, usa shadow e canary quando ammessi e prova il fallback.
Enable: consegna agli owner un decision record, aggiorna runbook e documentazione e insegna al team a riconoscere i segnali di ritorno.
Porta workflow, casi e vincoli a MAIKER HUB per progettare automazioni e agent AI con n8n. Un modello nuovo merita produzione solo quando il sistema che lo circonda resta comprensibile e reversibile.
Domande frequenti
Basta confrontare benchmark pubblici?
No. I benchmark aiutano a conoscere il modello, ma non provano prompt, tool, retrieval, dati e regole del tuo workflow. La decisione richiede casi rappresentativi del processo.
Shadow mode e canary sono la stessa cosa?
No. In shadow la candidate osserva una copia degli input ma il suo output non guida il lavoro. Nel canary una quota limitata usa davvero la candidate, con gate e possibilità di ritorno.
Posso cambiare modello e prompt insieme?
Puoi farlo, ma stai rilasciando una nuova configurazione completa e perdi l'attribuzione della differenza. Registralo esplicitamente e confronta il pacchetto, non il solo modello.
Quando serve ripetere lo stesso test?
Quando il comportamento può variare e la variabilità conta. Aumenta le ripetizioni sui casi ad alto rischio, sugli esiti instabili e sulle chiamate tool.
Il rollback tecnico è sufficiente?
No. Serve sapere anche come continua il processo se la baseline non torna disponibile o se l'incidente riguarda dati e azioni già avviate. Per questo il fallback comprende tecnologia, persone e comunicazione.