Come progettare il contesto di un agent AI
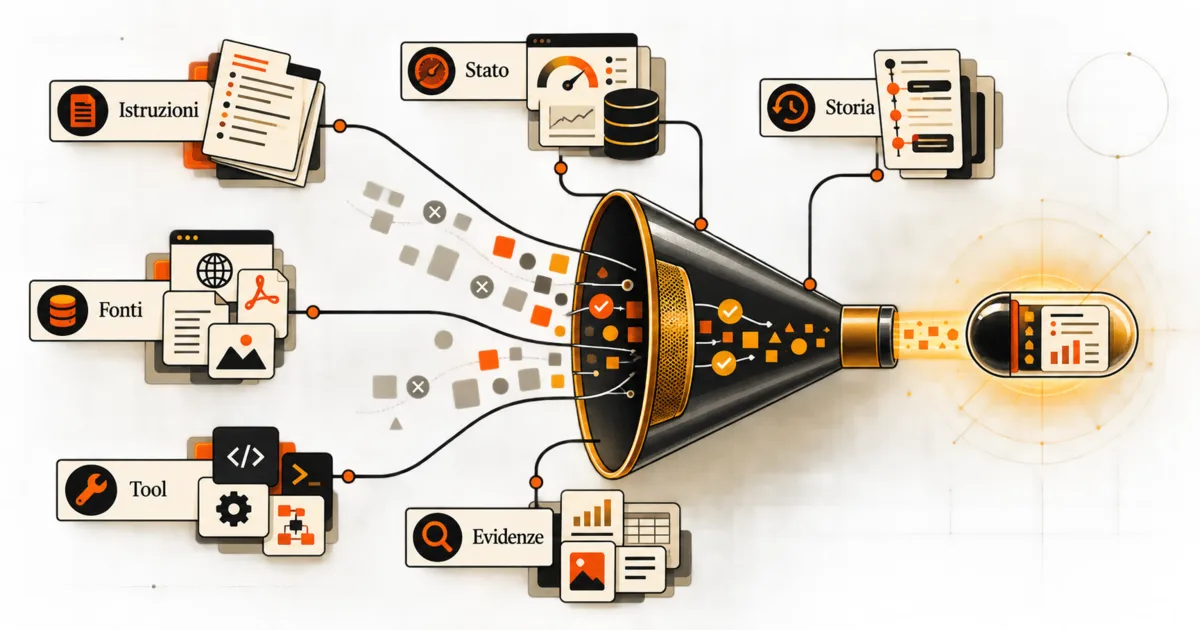
Un agent AI non ragiona su tutto ciò che la tua azienda sa. Ragiona su ciò che entra nella chiamata corrente: istruzioni, messaggi, tool, frammenti recuperati, risultati intermedi ed esempi.
Se manca un vincolo decisivo, il modello non può ricostruirlo. Se carichi ogni documento “per sicurezza”, le fonti importanti competono con materiale irrilevante. Se mescoli stato applicativo e testo per il modello, rischi che un'informazione privata venga trattata come parte della conversazione.
L'ingegneria del contesto progetta questa vista temporanea. L'obiettivo non è riempire la finestra disponibile. È fornire il più piccolo insieme di informazioni ad alto segnale che permetta il comportamento desiderato e una verifica successiva.
Il contesto non è un prompt più lungo
Il prompt descrive soprattutto ruolo, obiettivo, regole ed eventuali esempi. Il contesto comprende anche ciò che cambia durante il lavoro:
richiesta corrente
stato del caso
messaggi precedenti
fonti recuperate
risultati dei tool
elenco dei tool disponibili
note e decisioni persistenti
limiti residui del run
Anthropic descrive il context engineering come il passaggio dalla sola scrittura delle istruzioni alla cura dell'intero insieme di token disponibile al modello. In un agente, questo insieme cambia a ogni passo.
La domanda corretta non è quanto contesto posso inserire? ma:
Quale informazione deve essere visibile adesso perché il modello scelga la prossima azione corretta e perché noi possiamo verificarla?
Una finestra più ampia riduce alcuni vincoli di capienza. Non elimina contenuto contraddittorio, obsoleto, non autorizzato o poco pertinente.
Separa i sei strati del contesto
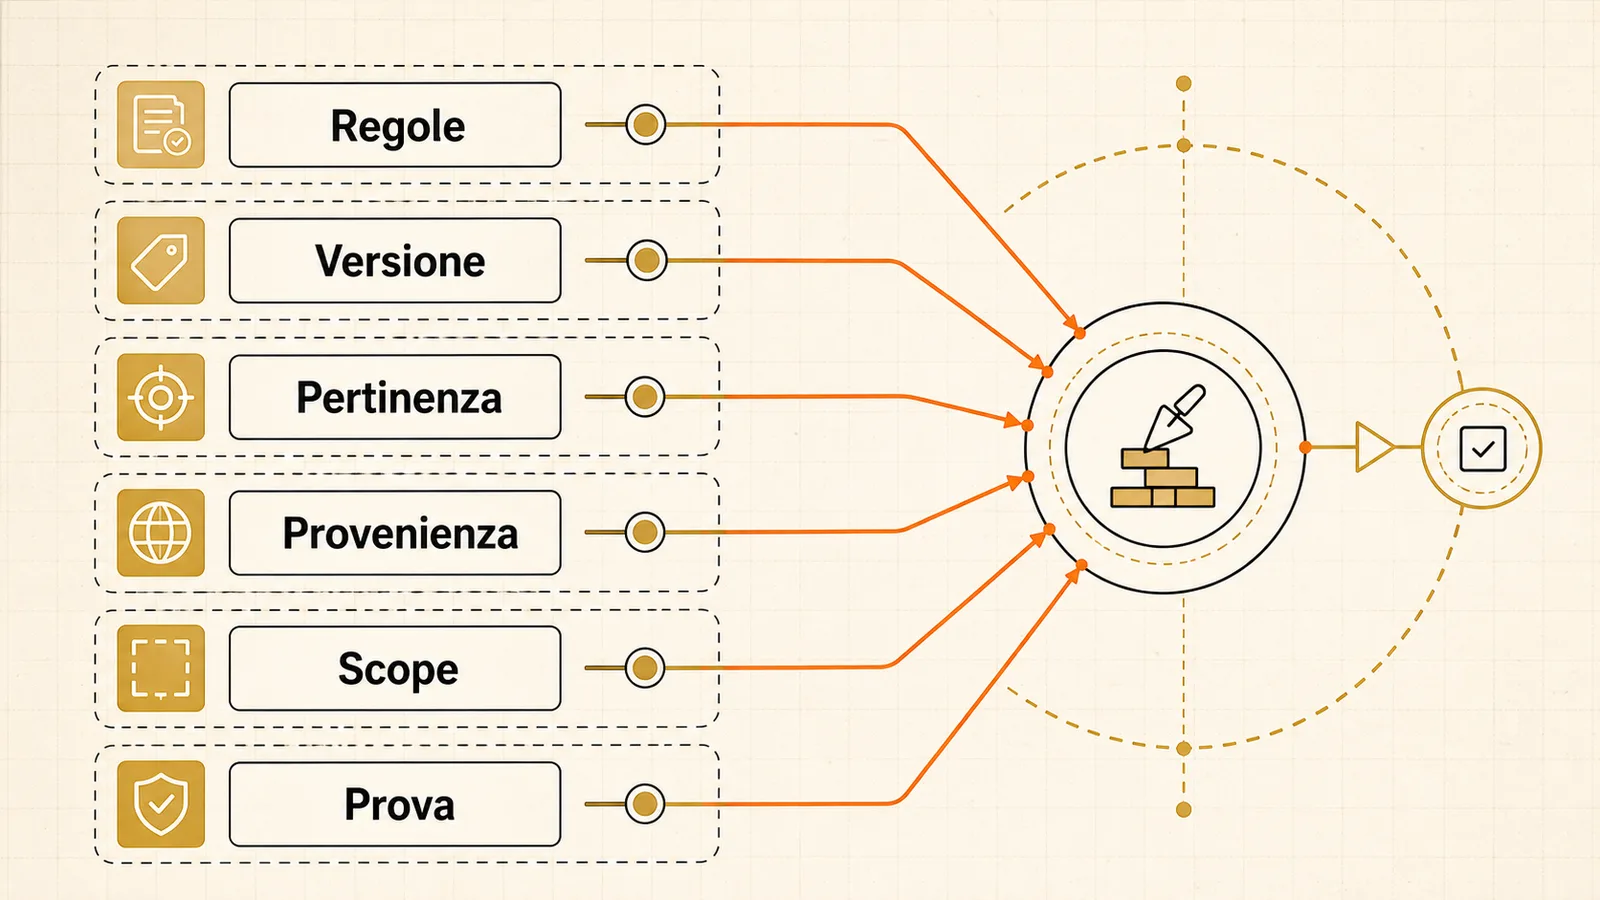
Tratta il contesto come una composizione di strati con owner e regole diverse.
Strato | Contenuto | Domanda di controllo |
|---|---|---|
Istruzioni | ruolo, obiettivo, limiti, formato | quale regola prevale in caso di conflitto? |
Stato | ID, fase, decisioni, scadenze, autorizzazioni | qual è la versione corrente? |
Storia | messaggi e azioni precedenti | che cosa serve davvero al prossimo passo? |
Conoscenza | fonti, documenti, record recuperati | provenienza e freschezza sono visibili? |
Capacità | tool, schemi, descrizioni, permessi | perché questo tool è esposto ora? |
Evidenze | output, ricevute, errori, valutazioni | che cosa è osservato e che cosa è ipotesi? |
Non concatenare questi strati in un'unica stringa senza identità. Se una fonte aggiornata contraddice una nota vecchia, l'agente deve poter riconoscere tipo, data e autorità di entrambe.
Ogni strato ha un lifecycle. Le istruzioni possono cambiare con una release. Lo stato cambia durante il run. La conoscenza ha date e versioni. I tool possono essere abilitati per singolo caso. Le evidenze crescono dopo ogni azione.
Tieni il contesto applicativo fuori dal modello
OpenAI Agents SDK distingue il contesto locale disponibile a codice, callback e tool da quello visibile al modello. L'oggetto locale non viene inviato all'LLM.
Questa separazione è utile per:
client di database e logger
identità e tenant
policy di autorizzazione
segreti e riferimenti a credenziali
funzioni per recuperare dati
contatori e limiti del run
stato di approvazione
Il modello può sapere questa azione richiede approvazione. Non ha bisogno del token che applica l'approvazione o dell'intero profilo di accesso.
Un errore comune è serializzare l'oggetto applicativo nel prompt per comodità. Così dipendenze, identificatori interni e dati non necessari diventano testo che il modello può ripetere o usare in modo inatteso.
Costruisci invece un adattatore:
stato locale protetto
        ↓ selezione e policy
vista per il modello
        ↓ output strutturato
validazione locale
        ↓
azione o nuovo stato
Il contratto degli input di un workflow AI aiuta a definire quali dati possono diventare parte della vista e come rifiutare input incompleti.
Crea un manifest del contesto
Prima del testo finale, componi un manifest machine-readable:
context_build_id: cb_20260903_1021
task_type: classify_supplier_request
instruction_ref: supplier-triage@8
state_ref: request_701@3
history_policy: decisions_and_last_two_turns@2
knowledge:
  - ref: procedure_supplier_intake@12
    retrieved_at: 2026-09-03T10:20:51+02:00
    reason: required_by_task
tools:
  - name: lookup_supplier
    schema_hash: 71bd...
    enabled_reason: verify_existing_record
excluded:
  - category: prior_unrelated_thread
    reason: not_required
  - category: contact_notes
    reason: contains_unnecessary_pii
budget:
  instructions: 1200
  history: 900
  knowledge: 2400
  tool_results: 1200
Il budget non deve essere identico per ogni modello o task. Serve a rendere intenzionale la composizione. Se il blocco conoscenza raddoppia, vuoi sapere perché.
Conserva hash o versioni per le componenti stabili. L'output può così essere collegato al contesto realmente usato, non alla configurazione che pensavi fosse attiva.
Recupera conoscenza quando serve
Caricare all'inizio ogni procedura, manuale e conversazione sembra prudente. In realtà rende il contesto più costoso e meno leggibile.
Il retrieval just-in-time mantiene riferimenti leggeri e recupera il contenuto quando il prossimo passo lo richiede. Un agente che deve classificare una richiesta può iniziare con tassonomia e criteri. Recupera il contratto completo soltanto se una classe dipende da una clausola concreta.
Applica una sequenza verificabile:
formula la domanda di retrieval
identifica raccolte e filtri ammessi
recupera candidati con ID e score
applica regole di autorità e freschezza
seleziona frammenti minimi
registra perché sono entrati
collega le affermazioni alle fonti usate
Non lasciare che il modello trasformi una bassa similarità in una fonte autorevole. Ranking semantico e autorità documentale sono segnali diversi.
Se il retrieval non trova una prova necessaria, il contesto deve contenere l'assenza come stato. Inserire il documento “più vicino” nasconde il gap.
Ordina per autorità e momento d'uso
La posizione non risolve da sola i conflitti, ma una struttura coerente aiuta il modello e i controlli.
Un possibile ordine è:
istruzioni di sistema e policy stabili
obiettivo e contratto del task
stato corrente e autorizzazioni visibili
fonti canoniche selezionate
esempi pertinenti
storia recente e decisioni precedenti
risultati dell'ultimo tool
richiesta del prossimo passo
Se due fonti hanno livelli diversi, dichiaralo. Procedura approvata v12 e nota dell'operatore non sono equivalenti.
Rendi espliciti:
source ID
owner
versione o data
ambito
stato di approvazione
momento del retrieval
eventuale sostituzione
L'agente non dovrebbe dedurre l'autorità dal tono professionale del testo.
Esponi solo i tool necessari
Anche nome, descrizione e schema di un tool occupano contesto e influenzano la scelta del modello.
Un inventario di 80 tool può essere corretto come catalogo. Non è necessariamente corretto come set disponibile per ogni richiesta.
Filtra i tool per:
task corrente
stato del workflow
tenant e identità
autorizzazioni già ottenute
conseguenza dell'azione
disponibilità della dipendenza
compatibilità dello schema
Descrizioni sovrapposte creano routing ambiguo. search_records e find_customer_data potrebbero sembrare intercambiabili anche se hanno scope e privacy diverse.
Misura tool proposti, tool esposti, tool chiamati, chiamate rifiutate e tool mai usati. Un tool sempre presente e mai necessario è rumore e superficie di rischio.
L'inventario dei workflow AI in azienda aiuta a risalire da tool e dipendenze al processo e all'owner organizzativo.
Gestisci storia e memoria come superfici diverse
La storia è la sequenza degli eventi di una sessione. La memoria è ciò che scegli di conservare e rendere recuperabile oltre quel momento. Lo stato applicativo è la fonte di verità sul lavoro.
Non usare la conversazione come unico database. Una frase abbiamo già approvato può essere utile al dialogo, ma l'approvazione reale deve vivere in uno stato verificabile.
Le sessioni possono riproporre tutta la storia al modello. OpenAI documenta anche limiti, callback di selezione e compattazione. Questo permette di conservare un archivio completo e inviare una vista più piccola.
Per ogni elemento storico decidi:
resta solo nell'audit?
entra nella memoria recuperabile?
modifica lo stato applicativo?
serve al prossimo turno?
contiene dati da scadere o isolare?
Una correzione dell'utente dovrebbe aggiornare il fatto canonico e rendere obsoleto quello precedente. Aggiungere semplicemente un nuovo messaggio lascia entrambi nel contesto.
Compatta senza perdere decisioni
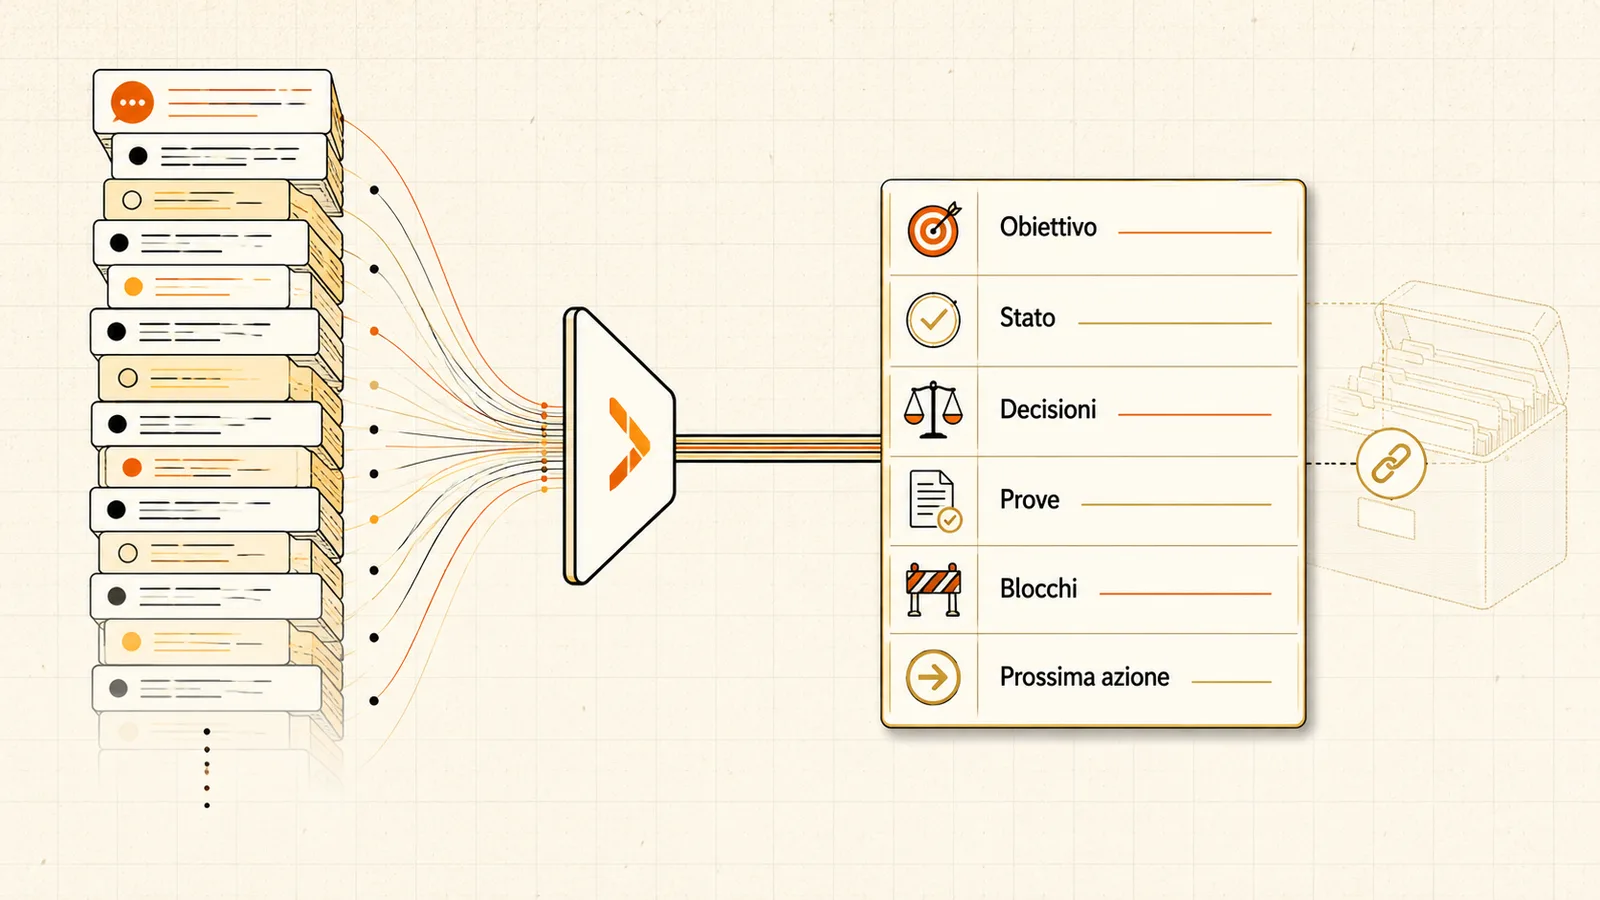
Quando il lavoro supera la finestra disponibile, non tagliare i messaggi più vecchi alla cieca. La compattazione crea un nuovo artefatto che conserva ciò che serve per continuare.
Una nota di continuità dovrebbe includere:
obiettivo e definizione di completamento
stato corrente
decisioni con motivo e owner
prove raccolte e riferimenti
errori non risolti
azioni già tentate
vincoli e divieti
prossima azione
elementi esclusi intenzionalmente
compaction_id: cp_77
derived_from:
  first_event: ev_001
  last_event: ev_148
goal: verify_supplier_application
current_state: evidence_review
decisions:
  - id: dec_19
    outcome: request_missing_certificate
    evidence_ref: rule_certification@5
open_blocks:
  - missing_current_certificate
next_action: prepare_review_note
excluded_detail_ref: audit://session_771/events
La compattazione è un cambiamento del contesto e va valutata. Confronta casi lunghi con e senza compattazione. Controlla omissioni di divieti, duplicazione di azioni, perdita delle fonti e decisioni riaperte.
Distingui fatti, ipotesi e istruzioni
Un blocco recuperato può contenere frasi imperative. Se proviene da una pagina esterna, non deve diventare un'istruzione per l'agente.
Etichetta i contenuti:
[POLICY] regola applicativa autorizzata
[TASK] obiettivo del run
[FACT] dato osservato con fonte
[CLAIM] affermazione da verificare
[HYPOTHESIS] interpretazione non confermata
[EXTERNAL_CONTENT] testo non fidato
[TOOL_RESULT] risultato strutturato
Queste etichette non sostituiscono sandbox e validazione. Rendono però il contratto leggibile e permettono test mirati.
La checklist per verificare un output AI completa il lavoro sul lato opposto: il contesto governa ciò che entra, la verifica governa ciò che può uscire o proseguire.
Valuta la costruzione del contesto
Un eval del modello non basta se il difetto nasce prima della chiamata.
Registra per caso:
componenti candidate e selezionate
token per strato
fonte e versione
tool esposti
elementi esclusi e motivo
compattazione applicata
output e disposizione finale
Crea test specifici:
fonte necessaria assente
due procedure in conflitto
documento scaduto con score alto
storia con PII non necessaria
tool vietato ma semanticamente pertinente
memoria corretta dopo una rettifica
compattazione che perde un divieto
stato locale diverso da quello raccontato in chat
retrieval contaminato da istruzioni esterne
richiesta che richiede astensione
Le metriche utili includono precisione del retrieval, copertura delle prove, token non usati, tool esposti senza uso, conflitti intercettati e differenza di qualità dopo pruning.
Più token non è una metrica di completezza. Un contesto può essere lungo e mancare proprio la decisione che conta.
Esempio fittizio: triage di una richiesta fornitore
Un assistente deve classificare una richiesta come nuovo fornitore, aggiornamento anagrafica o documento mancante.
Il sistema conserva una storia di 42 messaggi, tre procedure e note commerciali. Il costruttore del contesto:
prende istruzioni
supplier-triage@8legge lo stato
request_701@3esclude le note commerciali perché non servono e contengono PII
include l'ultima decisione dell'operatore
recupera due paragrafi dalla procedura approvata v12
espone
lookup_supplierin sola letturanon espone il tool che aggiorna l'anagrafica
Il modello trova un ID esistente e propone aggiornamento anagrafica. Il validatore nota che manca la prova del campo cambiato. Il sistema recupera il documento allegato, aggiunge il frammento pertinente e ripete il solo passo di classificazione.
Il trace mostra due build del contesto, non due tentativi indistinguibili. La seconda contiene una fonte in più e mantiene lo stesso stato. Nessun dato commerciale è entrato nella chiamata.
Think, Build, Enable applicato al contesto
Think: definisci task, fonti autorevoli, stato canonico, dati vietati e prova necessaria per ogni decisione.
Build: separa locale e modello, componi sei strati, recupera just-in-time, filtra tool e storia e versiona ogni build.
Enable: assegna owner a istruzioni e fonti, misura token e utilità, prova compattazione e correggi i difetti nel costruttore, non solo nel prompt.
Porta task, fonti e tool a MAIKER HUB per progettare automazioni e agent AI con n8n. Il contesto migliore non è quello che contiene tutto. È quello che rende la prossima decisione possibile, verificabile e limitata.
Domande frequenti
Context engineering e prompt engineering sono la stessa cosa?
No. Il prompt è uno strato. Il context engineering governa anche stato, storia, fonti, tool, risultati intermedi e compattazione a ogni chiamata.
Devo usare sempre tutta la finestra del modello?
No. Usa ciò che serve al task e misura le omissioni. Riempire la finestra può aumentare rumore, costo e conflitti.
La memoria deve entrare interamente nel contesto?
No. Conserva la memoria nel sistema previsto e recupera gli elementi pertinenti con scopo, provenienza e regole di privacy.
Come gestisco una conversazione molto lunga?
Separa storia completa e vista per il modello. Limita o filtra la storia e crea compattazioni strutturate con decisioni, prove, blocchi e prossima azione.
Il modello deve vedere tutti i tool disponibili?
Solo quelli necessari e ammessi nel punto corrente. Tool inutili o sovrapposti occupano contesto e rendono più ambiguo il routing.