Come usare un circuit breaker in un workflow AI
La dipendenza risponde in 18 secondi, poi va in timeout. Il workflow prova ancora. Cinquanta casi dopo, il servizio a valle è sempre fermo e la coda a monte è piena di lavoro che non può chiudersi.
Qui serve un circuit breaker: un controllo che interrompe le chiamate verso una dipendenza quando gli ultimi segnali dicono che un nuovo tentativo ha poche possibilità di riuscire. Il processo può fallire subito, usare un percorso degradato oppure mettere il caso in attesa. Dopo una finestra definita, lascia passare poche prove e decide se riaprire.
Il punto scomodo è questo: un breaker configurato male sposta il guasto. Può proteggere il servizio a valle e lasciare gli utenti davanti a risposte vecchie, code senza owner o casi persi. Va progettato insieme al comportamento del processo, non come una libreria aggiunta alla fine.
Distingui i controlli prima di aggiungerne uno
Retry, circuit breaker, fallback e arresto di emergenza rispondono a domande diverse.
Controllo | Domanda | Effetto |
|---|---|---|
Retry | l'errore è transitorio e lo stesso tentativo può riuscire? | ripete entro un budget |
Circuit breaker | vale ancora la pena chiamare questa dipendenza? | blocca o limita la chiamata |
Fallback | come continua il servizio senza quella dipendenza? | usa un percorso degradato |
Kill switch | dobbiamo fermare una capacità o un agent? | revoca l'esecuzione nel perimetro definito |
Dead-letter queue | come disponiamo i casi già falliti? | isola, diagnostica e prepara il recupero |
Microsoft separa esplicitamente retry e circuit breaker. Il retry presume che un nuovo tentativo possa riuscire. Il breaker impedisce di ripetere un'operazione che, in quel momento, è probabilmente destinata a fallire.
Prima di costruirlo, metti a posto i retry idempotenti del workflow AI. Se ogni tentativo può duplicare una conseguenza, il breaker riduce il volume del problema ma non lo risolve.
Scrivi il contratto della dipendenza
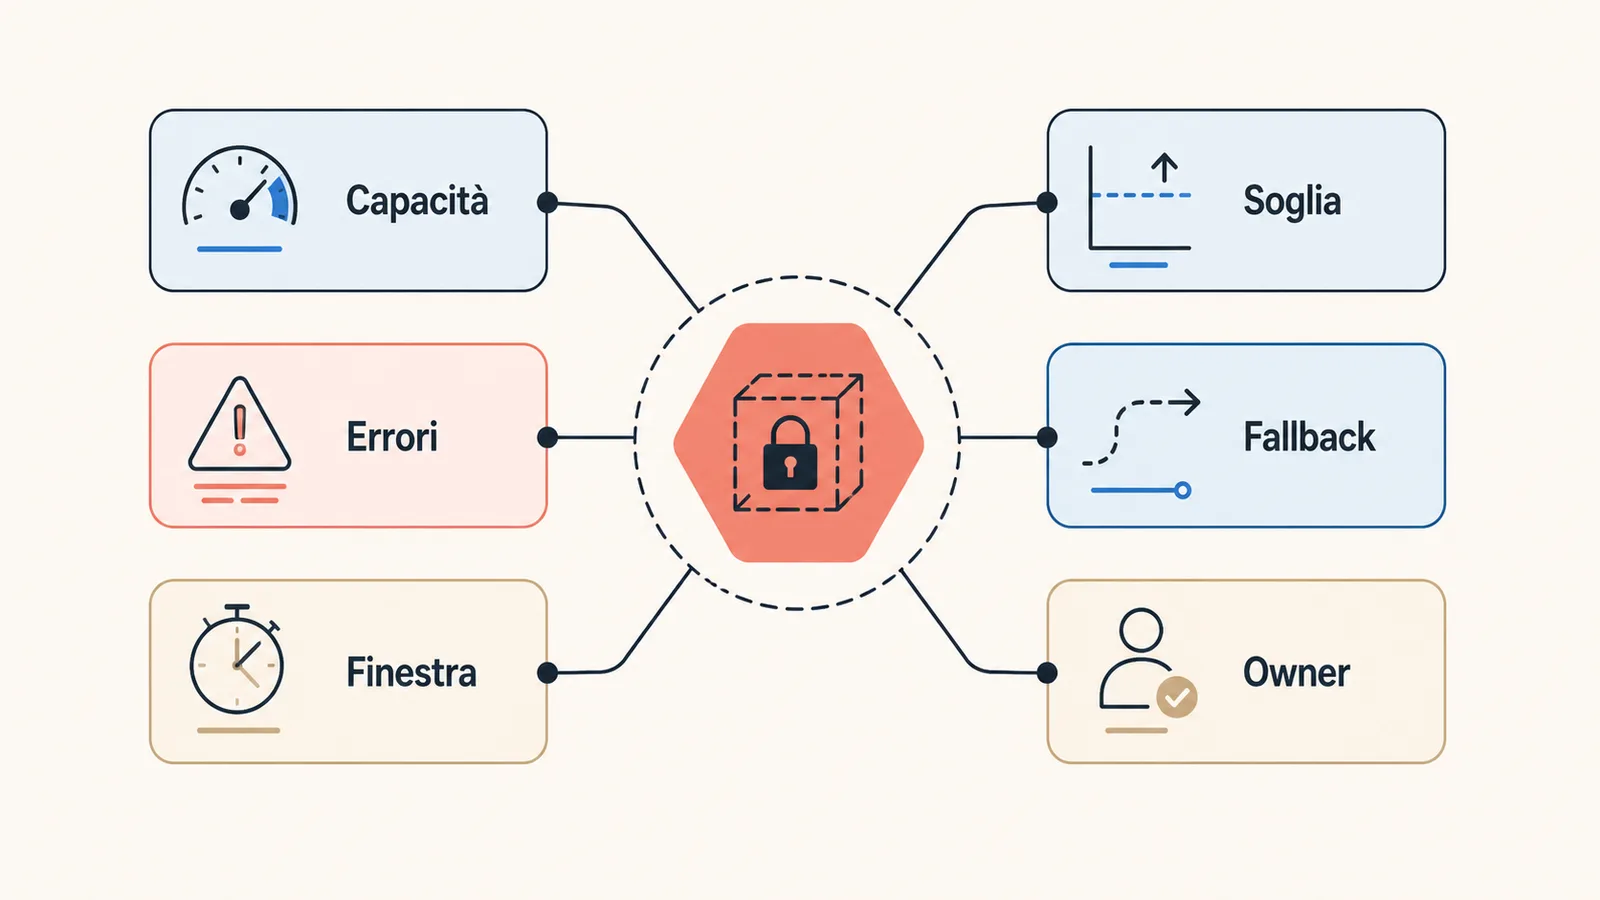
Servizio non disponibile è troppo poco. Il breaker deve sapere quale capacità protegge, quali errori contano e cosa restituisce quando apre.
Una scheda minima può contenere:
dependency_id: knowledge-search
protected_operation: retrieve-approved-documents
timeout_ms: defined_from_observed_baseline
counted_failures:
  - timeout
  - connection_refused
  - rate_limit_without_safe_wait
ignored_failures:
  - invalid_user_query
window: rolling
open_rule: approved_threshold
open_action: return_degraded_response
half_open_budget: limited_probes
recovery_rule: consecutive_valid_probes
manual_authority: platform_owner
Un errore dell'utente non dimostra che il motore di ricerca sia guasto. Un output sotto la soglia editoriale non dimostra che l'API non risponda. Conta soltanto i segnali che descrivono la dipendenza protetta.
Definisci anche la granularità. Un breaker unico per tutto il provider può fermare funzioni sane insieme a quella guasta. Uno per singola richiesta produce una frammentazione ingestibile. Il confine utile spesso coincide con una capacità e un profilo di errore: ricerca documenti, generazione, invio a un gestionale, conversione di un file.
Scegli segnali e soglie osservabili
AWS indica indisponibilità, timeout e alta latenza tra i casi in cui il pattern è utile. Questi segnali vanno letti dentro una finestra, altrimenti tre errori distribuiti in una giornata possono pesare come tre timeout consecutivi in dieci secondi.
Per ogni segnale registra:
fonte e timestamp
operazione e versione
esito tecnico, non interpretazione libera
durata e timeout applicato
eventuale istruzione
retry-afterquota o limite noto
conseguenza già prodotta
La soglia non arriva da un articolo. Arriva da baseline, SLO, capacità della dipendenza e costo del fallimento. Un flusso usato due volte al giorno non ha lo stesso profilo di un endpoint chiamato cento volte al minuto.
Parti con una regola deterministica e spiegabile. Le soglie adattive citate da alcuni provider possono essere utili, ma aggiungono un secondo sistema da testare. Se non sai ricostruire perché il circuito si è aperto, il recupero diventa un altro esperimento.
Tratta closed, open e half-open come stati operativi
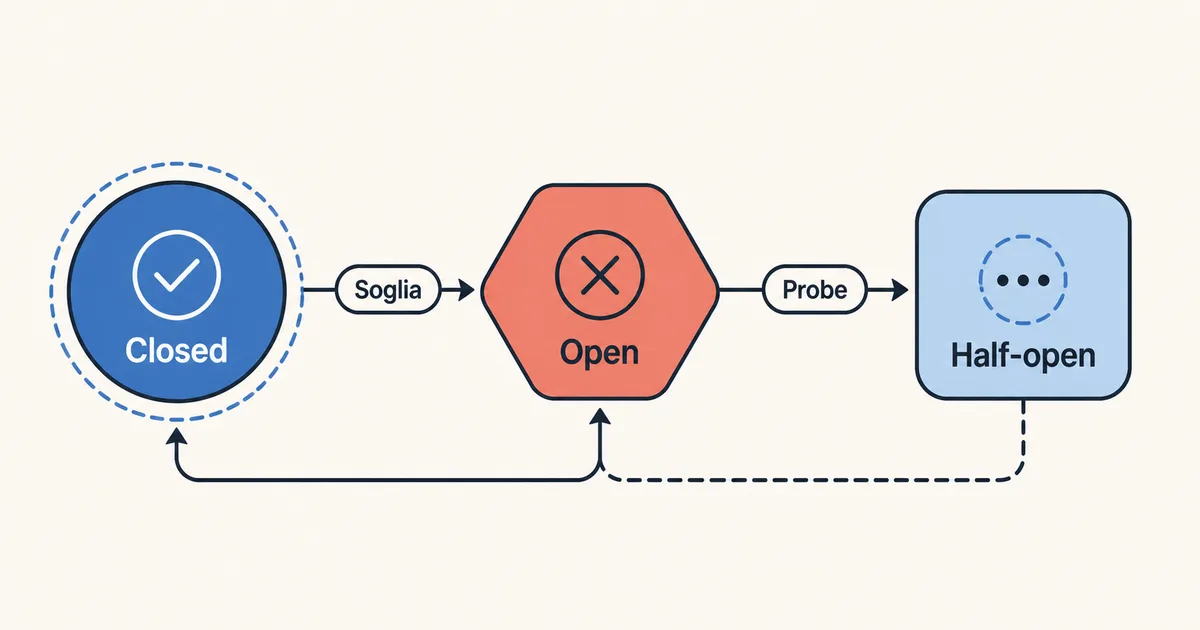
Nello stato closed le richieste passano e il breaker aggiorna i segnali recenti. Al superamento della regola, entra in open.
Open significa che la chiamata non parte. Il workflow deve produrre un esito esplicito, per esempio dependency_unavailable, e scegliere il percorso previsto. Aspettare lo stesso timeout senza chiamare il servizio non serve a niente.
Dopo la finestra di recupero, half-open lascia passare un numero limitato di probe. Microsoft usa proprio questo stato per evitare che una dipendenza appena ripresa riceva subito tutto il traffico arretrato. Un probe valido chiude solo se soddisfa il contratto completo: codice atteso, tempo accettabile e risposta strutturalmente utilizzabile.
La transizione richiede una ricevuta:
breaker_id
from_state
to_state
reason_code
evidence_window
observed_failures
probe_ids
config_version
changed_at
Senza config_version, una modifica della soglia può sembrare una guarigione del servizio. Senza probe_ids, nessuno sa quali richieste hanno giustificato la chiusura.
Disegna il percorso degradato prima dell'apertura
Aprire il circuito è metà del lavoro. L'altra metà è decidere cosa vede chi usa il processo.
Le opzioni comuni sono poche:
fallimento esplicito e ritentabile dall'utente
risposta parziale con limite dichiarato
dato in cache con età visibile
passaggio a revisione umana
accodamento senza esecuzione, con scadenza e capacità massima
completamento manuale su un percorso già provato
Il fallback manuale di un workflow AI deve indicare chi prende il caso, con quali dati e come lo riconcilia. Passa all'operatore non basta se l'operatore non ha accesso alla fonte o riceve cento casi in cinque minuti.
Una cache può andare bene per un catalogo non critico. È pericolosa quando la freschezza cambia la decisione. Una risposta parziale può aiutare su una ricerca interna, ma deve dire quale parte manca. Il breaker non autorizza a riempire il vuoto con conoscenza del modello.
Riapri con una prova limitata
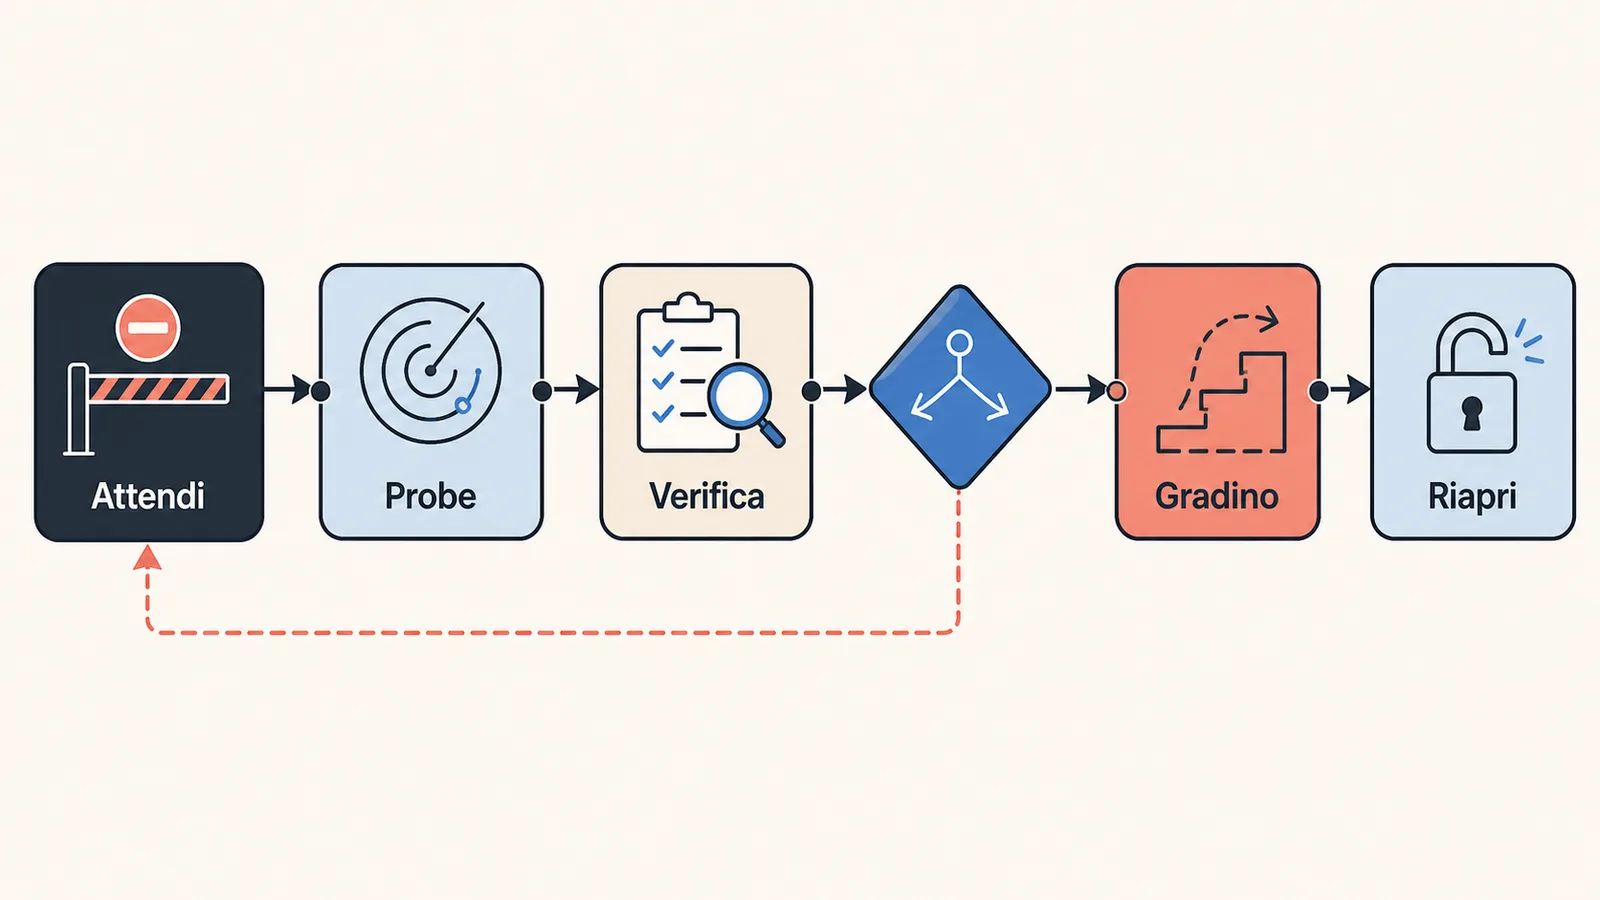
La scadenza del timer non dimostra che la dipendenza sia guarita. Autorizza soltanto una prova.
Costruisci il probe con un caso rappresentativo e senza conseguenze irreversibili. Verifica almeno risposta, latenza, schema e dipendenze secondarie. Se il servizio risponde 200 ma restituisce un payload vuoto, il probe non è verde.
Poi aumenta il traffico per gradini. Il primo gradino può contenere casi sintetici. Il secondo, pochi casi reali a basso impatto. Solo dopo riapri la coda ordinaria.
Il passaggio half-open -> closed deve avere una stop rule. Al primo errore della stessa classe si torna in open, oppure si applica la regola concordata. Evita un mezzo stato permanente in cui una parte del traffico passa senza che nessuno sappia se il servizio è ripristinato.
Collega breaker, SLO e monitoraggio
Il breaker produce eventi che devono entrare nel monitoraggio del workflow AI in produzione. Conta aperture, durata, chiamate evitate, probe riusciti, riaperture fallite e volume passato al fallback.
Lo SLO del workflow AI aiuta a decidere quale degradazione è accettabile. Una capacità può restare disponibile con dati in cache. Un'altra deve dichiararsi indisponibile appena perde la fonte autorevole.
Misura anche ciò che il breaker nasconde. Se le chiamate evitate salgono e gli alert tecnici scendono, la dipendenza non è diventata sana. Il breaker sta facendo il suo lavoro. Serve ancora un owner che rimuova la causa.
Prova i guasti che vuoi contenere
Un test utile copre almeno questi casi:
timeout isolato che non apre il circuito
serie di errori che supera la soglia
errore di business escluso dal conteggio
apertura con risposta degradata corretta
saturazione del fallback o della coda
probe riuscito ma lento
probe con schema errato
chiusura riuscita e smaltimento graduale
comando manuale di apertura e chiusura autorizzato
AWS raccomanda che gli amministratori possano forzare lo stato. Quel comando va protetto, versionato e registrato. Force closed durante un guasto non ripara nulla e può riattivare la cascata.
Esempio fittizio
Un assistente interno cerca procedure approvate e prepara una risposta con citazioni. Il motore di ricerca supera il timeout in sei chiamate su otto dentro una finestra definita. Il breaker passa a open.
Le nuove richieste non chiamano il motore. L'assistente risponde che la ricerca documentale è temporaneamente indisponibile e permette di aprire un ticket interno. Le richieste già iniziate conservano il proprio identificatore, ma non vengono rieseguite alla cieca.
Dopo la finestra di recupero, il sistema invia tre probe sintetici con documenti noti. Due rispondono nei tempi, il terzo restituisce zero risultati. Il circuito torna open. Il team scopre un indice incompleto, lo ricostruisce e ripete gli stessi probe. Tutti e tre passano, poi cinque casi reali a basso impatto chiudono correttamente. Il breaker torna closed e la coda viene riaperta a tranche.
Il dato importante non è che il servizio ha risposto. È che ricerca, schema e citazioni sono tornati nello stato previsto.
Think, Build, Enable applicato al circuit breaker
Think: scegli dipendenza, errori contati, finestra, soglia, percorso degradato e autorità manuale.
Build: crea la macchina a stati, le ricevute, i probe, i limiti del fallback e gli eventi di monitoraggio.
Enable: consegna il runbook, prova apertura e recupero, fai riconciliare i casi a chi gestisce il processo.
Porta dipendenze, errori e percorsi degradati a MAIKER HUB per progettare automazioni e agenti AI con n8n. Un breaker utile non evita ogni errore. Evita che un errore noto continui a consumare risorse e fiducia.
Domande frequenti
Circuit breaker e retry possono convivere?
Sì. Il retry gestisce pochi errori classificati come transitori. Il circuit breaker interrompe i nuovi tentativi quando il pattern recente indica un guasto persistente.
Devo avere un breaker per ogni tool chiamato dall'agent?
No. Il confine dipende da capacità, isolamento e profilo di errore. Troppi breaker rendono lo stato difficile da leggere. Uno solo può fermare dipendenze sane.
Il circuito può chiudersi dopo un solo probe?
Solo se il rischio e la baseline lo giustificano. Per molti processi è più prudente chiedere più prove consecutive e riaprire il traffico per gradini.
Cosa succede ai casi arrivati mentre il circuito è aperto?
Seguono il percorso dichiarato: errore esplicito, fallback, revisione o coda limitata. Ogni opzione richiede owner, capacità e criterio di riconciliazione.
Il circuit breaker sostituisce il monitoraggio?
No. Produce segnali e protegge la dipendenza. Il monitoraggio mostra durata, volume, fallback e cause ancora aperte.