Come usare la cache in un workflow AI senza servire risposte vecchie
La cache promette meno latenza e meno calcolo. Il rischio è riutilizzare la risposta giusta per il caso sbagliato.
In un workflow AI puoi mettere in cache il prefisso del prompt, un risultato di ricerca, la risposta di un'API o l'output finale del modello. Questi oggetti non hanno la stessa identità, durata o sensibilità. Trattarli come un unico “risultato già calcolato” crea collisioni silenziose.
Una cache affidabile è un contratto che risponde a quattro domande: quando due richieste sono equivalenti, quanto dura quell'equivalenza, come la verifichi e quale evento la annulla?
Separa quattro tipi di cache
Prima di ottimizzare, nomina ciò che vuoi riusare.
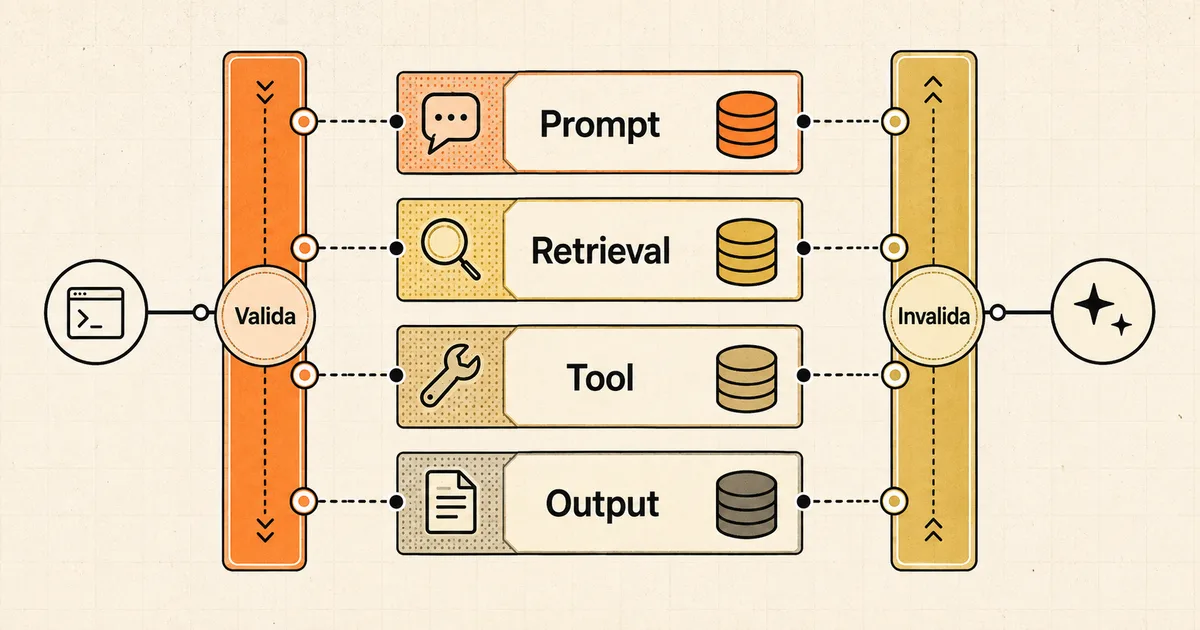
Livello | Che cosa riusa | Rischio principale |
|---|---|---|
Prompt cache del provider | calcolo su un prefisso identico | pensare che riusi una risposta o che sostituisca la cache applicativa |
Cache di retrieval | documenti o frammenti recuperati | fonte aggiornata ma risultato ancora considerato fresh |
Cache di tool | risposta di API o funzione | chiave incompleta, tenant errato, autorizzazione cambiata |
Cache di output | risposta finale del modello | risultato non più valido per stato, modello, policy o utente |
La prompt cache ottimizza l'elaborazione di input ripetuti. OpenAI e Anthropic documentano meccanismi basati su prefissi identici. Il modello continua a generare un nuovo output.
La cache di output fa l'opposto: restituisce un risultato precedente senza una nuova generazione. Richiede quindi controlli più severi su equivalenza e freschezza.
Non confondere nemmeno cache e memoria. La memoria conserva informazioni da recuperare in futuro. La cache conserva un calcolo riutilizzabile secondo una chiave e una policy di scadenza.
Definisci l'equivalenza prima della chiave
Una chiave hash non rende corretto il contenuto che hai deciso di hasharne.
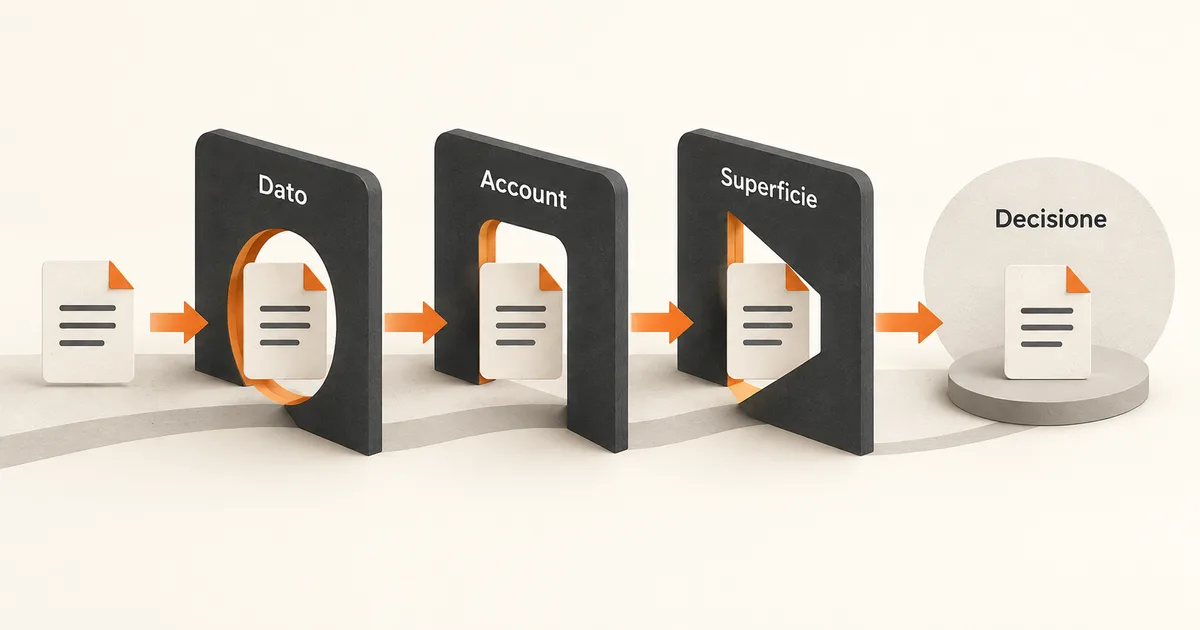
Per una classificazione, due richieste sono equivalenti solo se coincidono le superfici che possono cambiare l'esito:
input normalizzato
tenant e ambito dati
prompt o istruzione
modello e configurazione rilevante
schema di output
toolset
tassonomia o policy
versione delle fonti
lingua e locale
profilo di autorizzazione
Se ometti policy_version, una richiesta elaborata prima di una nuova regola può ricevere una risposta vecchia ma formalmente valida.
Scrivi l'equivalenza in prosa prima del codice:
Due richieste possono condividere un risultato soltanto se:
1. appartengono allo stesso tenant;
2. hanno lo stesso input normalizzato;
3. usano le stesse istruzioni, tassonomia e schema;
4. leggono la stessa versione delle fonti;
5. hanno lo stesso profilo di visibilità;
6. non è intervenuto un evento di invalidazione.
Se non riesci a spiegare l'equivalenza, non hai ancora una cache key.
Progetta la cache key come un manifest
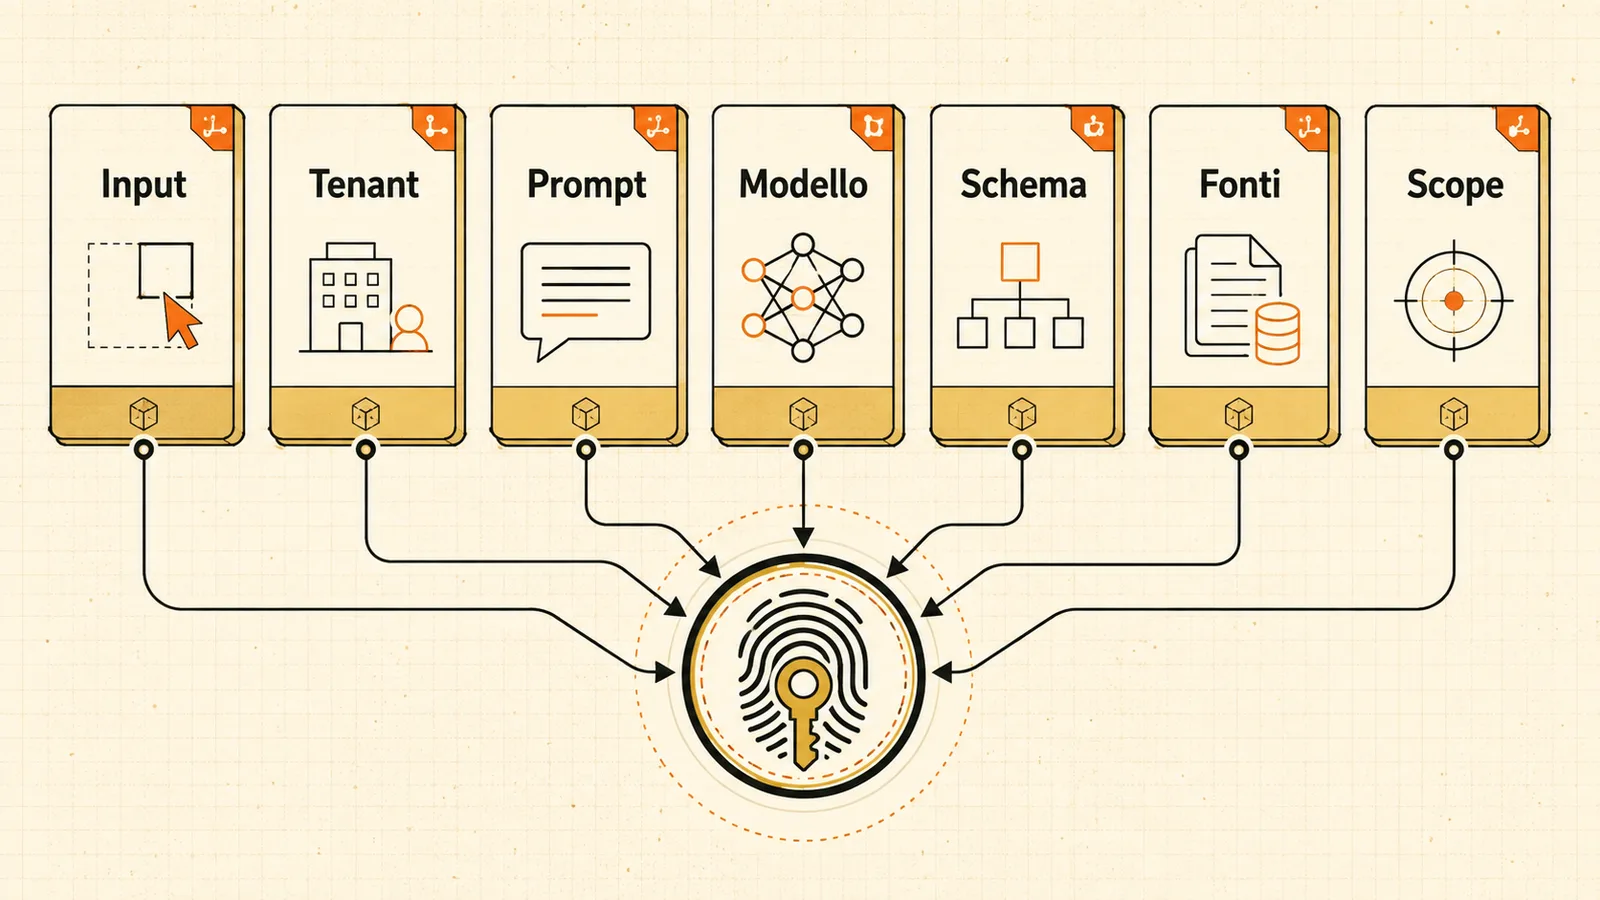
Una chiave leggibile in fase di debug può essere costruita da un manifest canonico:
cache_namespace: request_classifier
tenant_id: tenant_42
input_hash: 890a...
instruction_ref: request-classifier@11
model_config_ref: balanced-classification@4
output_schema: request-classification@3
taxonomy_ref: service-categories@9
source_snapshot: kb_2026-09-03T08:00Z
authorization_scope: support_read_only@5
locale: it-IT
Serializza in ordine stabile e calcola l'hash. Conserva anche il manifest o un riferimento, altrimenti una miss o una collisione resta opaca.
Evita questi campi:
timestamp corrente inserito sempre, perché rende ogni richiesta unica
intero payload in chiaro dentro una chiave o un log
identificatore casuale del run, se il calcolo dovrebbe essere condivisibile
solo il testo dell'utente, se fonti e policy cambiano l'esito
Decidi il namespace. Cache di sviluppo e produzione non devono incontrarsi. Anche due feature che usano lo stesso modello possono avere contratti diversi.
Il controllo delle modifiche di un workflow AI aiuta a elencare le versioni che devono partecipare alla chiave.
Usa la prompt cache per prefissi davvero stabili
OpenAI raccomanda di mettere istruzioni ed esempi stabili all'inizio e dati variabili alla fine, perché i cache hit richiedono corrispondenza del prefisso. Anthropic documenta una sequenza che comprende tool, system e messaggi fino al breakpoint.
Una struttura adatta può essere:
[tool e schema stabili]
[istruzioni versionate]
[esempi canonici]
[procedura stabile]
-------------------- breakpoint
[stato del caso]
[fonti recuperate ora]
[richiesta corrente]
Non spostare informazioni dinamiche in alto solo per comodità. Un timestamp, un ID di richiesta o un tool riordinato può cambiare il prefisso e azzerare i hit.
Misura i campi di usage previsti dal provider. Una funzione “abilitata” ma con zero token letti da cache non sta producendo il beneficio atteso.
Non basare il contratto applicativo sul TTL della prompt cache del provider. Durata, modelli supportati, breakpoint, isolamento e prezzi possono cambiare. Trattali come configurazione osservabile, non come proprietà eterna del sistema.
Assegna freschezza per tipo di dato
RFC 9111 offre un vocabolario utile: una risposta è fresh finché la sua età non supera la vita utile; se è stale, può richiedere validazione con l'origine. Le regole HTTP non si trasferiscono automaticamente a un workflow AI, ma il principio sì.
Non usare un unico TTL per ogni oggetto. Una pagina informativa pubblica e uno stato di approvazione non cambiano allo stesso ritmo.
Oggetto | Strategia possibile |
|---|---|
procedura versionata | valida finché la versione resta corrente |
elenco categorie | invalida alla pubblicazione di una nuova tassonomia |
disponibilità di un servizio | TTL breve più health check |
risultato di ricerca | lega allo snapshot dell'indice |
profilo di autorizzazione | ricalcola o valida a ogni azione sensibile |
output editoriale | lega a input, fonti e istruzioni; revisione umana se necessario |
La freschezza temporale non basta. Un record di cinque secondi può essere stale se un evento ne ha cambiato lo stato.
Conserva created_at, validated_at, source_version, expires_at e invalidation_reason. L'età senza provenienza dice poco.
Valida con l'origine quando il costo del dato stale è alto
Una cache può evitare di riscaricare un oggetto e comunque verificarne la versione.
Esempi:
confrontare ETag o hash del documento
leggere il numero di revisione di una policy
verificare
updated_atdi una tassonomiacontrollare l'owner dello stato
interrogare un endpoint di versione
Se il validatore coincide, estendi la freschezza. Se cambia, ricostruisci il valore e registra la causa della miss.
Per dati ad alto impatto, il default può essere validate-before-use. Una risposta più lenta è preferibile a un'autorizzazione vecchia.
Definisci anche il comportamento quando l'origine non è disponibile:
fail_closed: non usare lo staleserve_stale_read_only: mostra il dato con età e warning, senza azionifallback_manual: passa a una procedura umanaretry_later: conserva il lavoro senza ripetere side effect
La scelta dipende dalla conseguenza, non dal desiderio di mantenere il servizio verde.
Invalida per evento, non per speranza
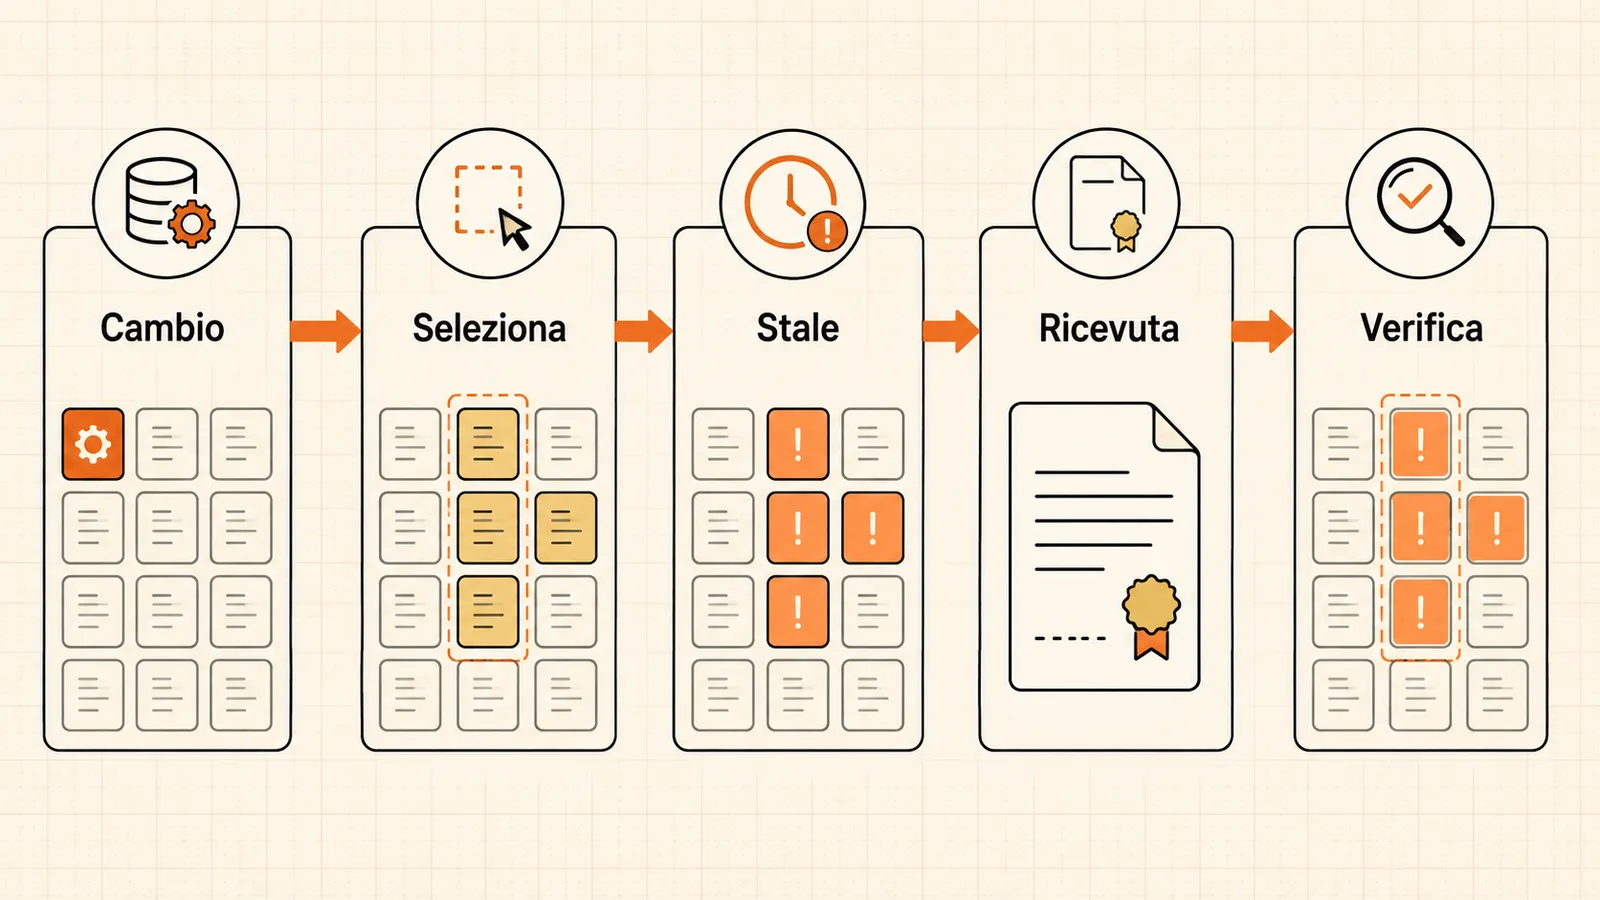
Un TTL lungo con tanto cambierà raramente non è una strategia.
Elenca gli eventi che rompono l'equivalenza:
nuova versione di prompt o policy
cambio modello o configurazione
schema modificato
tool aggiunto, rimosso o rinominato
fonte aggiornata o ritirata
permesso concesso o revocato
record corretto
tenant spostato
incidente o finding che rende il risultato non affidabile
Ogni evento produce:
namespace o tag interessati
momento effettivo
chiave o selettore di invalidazione
numero di entry rimosse o rese stale
ricevuta
verifica su una richiesta campione
Evita svuota tutto come unico strumento. È semplice ma può creare picchi, nascondere una selezione errata e cancellare evidenze utili. Usa versioni nelle chiavi quando possibile: la nuova versione crea naturalmente un nuovo spazio, mentre il vecchio può scadere senza essere servito.
Non mettere in cache un side effect
Puoi mettere in cache il risultato di lookup_order(42) se il contratto lo consente. Non puoi sostituire refund_order(42) con una risposta cache operazione completata.
Le azioni richiedono idempotenza e ricevute, non cache di output. Un retry deve verificare se l'effetto è avvenuto, non riutilizzare una frase precedente.
Se un agente chiede due volte la stessa azione:
controlla l'idempotency key
recupera la ricevuta dell'effetto
riconcilia stato locale e remoto
restituisci lo stato osservato
La cache può accelerare letture di supporto. Non deve simulare la conferma di una scrittura.
Isola tenant, identità e dati sensibili
Una cache condivisa aumenta il rischio di mostrare il risultato di un utente a un altro.
Includi nell'ambito almeno:
organizzazione o tenant
utente o ruolo, quando cambia la visibilità
regione o ambiente, quando rilevante
versione della policy
classificazione del dato
Non basta hasharne il contenuto. Se due tenant hanno lo stesso documento, la policy può comunque vietare la condivisione del calcolo.
Definisci che cosa non viene mai memorizzato:
segreti e credenziali
input con categorie sensibili non necessarie
risposte di tool ad alta volatilità
autorizzazioni come prova permanente
output che deve essere ricostruito con fonti correnti
Verifica la documentazione del provider su isolamento e retention della prompt cache. Queste proprietà non rendono automaticamente conforme la cache applicativa che gestisci tu.
Tratta l'output del modello come un artefatto versionato
Mettere in cache l'output finale può essere utile per task determinati e a basso rischio, come una spiegazione costruita su contenuto immutabile. È più delicato per classificazioni, raccomandazioni e testo personalizzato.
Registra:
input hash
contesto e fonti
modello e configurazione
prompt e schema
output hash
disposizione QA
età e invalidatori
Non assumere che lo stesso input generi sempre lo stesso output. La cache trasforma un risultato contingente in un risultato ripetuto. Prima verifica che quel riuso sia desiderato.
Per output letti da persone, mostra la data o la fonte quando la freschezza conta. Per output usati da software, valida lo schema e il dominio dei valori anche su un cache hit.
Osserva hit, miss e qualità
Il solo hit rate può premiare una cache troppo aggressiva.
Misura almeno:
hit rate per livello e namespace
token letti e scritti in prompt cache
latenza hit e miss
età al momento dell'uso
miss per versione, tenant, schema e fonte
invalidazioni per evento
entry stale intercettate
output corretti dopo cache hit
collisioni o leakage
bypass manuali
Collega questi dati al monitoraggio di un workflow AI in produzione. Un aumento dei hit insieme a un aumento delle correzioni è un segnale rosso, non un successo FinOps.
Conserva un campione di decisioni hit/miss con manifest, senza duplicare dati protetti. Devi poter spiegare perché una richiesta ha riusato proprio quella entry.
Introduci la cache per stadi
Non abilitare tutti i livelli nello stesso rilascio.
osserva richieste ripetute senza servire cache
costruisci chiavi e misura collisioni potenziali
abilita prompt cache del provider
aggiungi cache read-only su una fonte versionata
prova invalidazione e fallback
limita l'output cache a task a basso rischio
amplia solo dopo una finestra comparabile
Testa:
stessa richiesta, policy diversa
input uguale in due tenant
fonte aggiornata durante il TTL
revoca di un permesso
modello o schema cambiato
origine indisponibile
due miss concorrenti sulla stessa chiave
entry corrotta o incompleta
invalidazione parziale
cache hit che non supera la validazione a valle
Il registro degli incidenti AI in azienda può raccogliere stale response, collisioni e invalidazioni mancate come failure mode ripetibili.
Esempio fittizio: classificare richieste interne
Un workflow classifica richieste in quattro categorie. Il prompt contiene istruzioni stabili e 20 esempi; la richiesta e la fonte aggiornata cambiano.
Il team applica tre livelli:
prompt cache sul prefisso stabile
cache della tassonomia legata a
taxonomy@9nessuna cache dell'output finale durante il pilota
La chiave della tassonomia include tenant e versione. Quando taxonomy@10 viene pubblicata, un evento sposta il riferimento corrente. Le nuove richieste entrano in un namespace diverso; quelle vecchie restano leggibili per audit ma non vengono servite.
Dopo due settimane, il team valuta una cache di output per le sole richieste sintetiche della demo. Scopre che una normalizzazione elimina punteggiatura che in alcuni casi cambia il significato. Corregge la funzione prima di estendere il test.
Il beneficio deriva dalla prompt cache e dal riuso della tassonomia. Il team non ha dovuto memorizzare risposte utente né assumere che una classificazione precedente resti corretta.
Think, Build, Enable applicato alla cache
Think: definisci equivalenza, conseguenza di un dato stale, oggetti non memorizzabili e fonti di verità.
Build: separa i livelli, crea manifest e chiavi complete, aggiungi validatori, invalidazione per evento, isolamento e ricevute.
Enable: misura hit insieme a qualità, prova revoche e guasti, aggiorna la documentazione dei provider e amplia per stadi.
Porta workflow, profilo di traffico e vincoli a MAIKER HUB per progettare automazioni e agent AI con n8n. Una cache utile non è quella che risponde sempre. È quella che sa dimostrare quando può riusare e quando deve chiedere di nuovo alla fonte.
Domande frequenti
Prompt caching significa che il provider restituisce la stessa risposta?
No. Riusa calcolo su un prefisso compatibile; il modello genera comunque un nuovo output. La cache di output è una scelta applicativa diversa.
Qual è il TTL giusto per un workflow AI?
Non esiste un valore universale. Dipende da volatilità, rischio, validatori, disponibilità dell'origine e costo di un dato stale.
Posso usare solo il testo dell'utente come cache key?
Raramente basta. Includi le versioni di istruzioni, modello, schema, fonti, policy, tenant e visibilità che possono cambiare l'esito.
Devo cancellare tutta la cache a ogni modifica?
Non necessariamente. Versioni e namespace permettono di rendere inutilizzabile il vecchio spazio senza una cancellazione indiscriminata.
Posso mettere in cache l'esito di un'azione?
Non come prova dell'effetto. Per le scritture usa idempotency key, ricevuta e riconciliazione con il sistema esterno.